Vai trò giám sát con người trong tự động hóa nghiên cứu
Mục lục
- Giám sát nên tập trung vào điểm quyết định, không phải mọi thao tác
- Con người phải khóa câu hỏi, mục tiêu và tiêu chí thành công
- Kiểm soát nguồn và chuỗi bằng chứng quan trọng hơn kiểm tra văn phong đầu ra
- Con người cần can thiệp mạnh ở giả thuyết, suy luận và diễn giải
- Workflow phải có ngưỡng dừng, quyền phủ quyết và cơ chế chuyển cấp
- Giám sát phải kiểm tra quy trình, không chỉ sản phẩm cuối
- Mức giám sát nên thay đổi theo rủi ro và khả năng kiểm chứng
Tự động hóa có thể đảm nhiệm tìm kiếm, tổng hợp, phân tích và thực thi nhiều bước nghiên cứu, nhưng con người vẫn cần kiểm soát các quyết định có khả năng làm thay đổi hướng nghiên cứu, chất lượng bằng chứng và độ tin cậy của kết luận. Trọng tâm hiệu quả nhất là giám sát theo rủi ro tại những điểm quyết định quan trọng thay vì phê duyệt thủ công mọi thao tác của hệ thống.
Khi một workflow nghiên cứu có thể tự tìm tài liệu, lập giả thuyết, chạy phân tích, tổng hợp bằng chứng và tạo báo cáo, vai trò của con người không biến mất mà dịch chuyển lên một tầng khác. Con người không còn cần trực tiếp thực hiện mọi thao tác, nhưng phải giữ quyền xác định vấn đề nào đáng nghiên cứu, bằng chứng nào đủ sức hỗ trợ kết luận, sai lệch nào cần dừng workflow và kết quả nào có thể được chấp nhận.
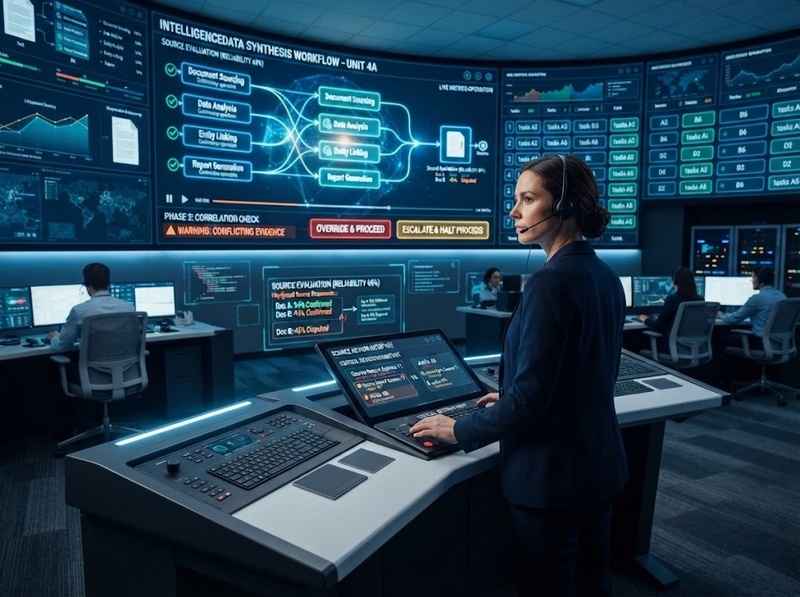
Điểm quan trọng vì vậy không phải là tăng số lần con người can thiệp. Một workflow yêu cầu phê duyệt sau mọi thao tác có thể đánh mất phần lớn lợi ích của tự động hóa. Ngược lại, một workflow hoàn toàn tự trị có thể khuếch đại lỗi từ một quyết định sai ở đầu chuỗi thành một báo cáo trông thuyết phục ở cuối chuỗi. Cách tiếp cận phù hợp hơn là giám sát theo điểm kiểm soát: đặt con người tại những bước mà một quyết định sai khó được phát hiện hoặc có khả năng lan truyền sang toàn bộ phần nghiên cứu phía sau.
NIST AI Risk Management Framework cũng coi việc xác định rõ vai trò, trách nhiệm và cơ chế giám sát trong cấu hình người–AI là một phần của quản trị rủi ro AI. OECD đồng thời nhấn mạnh năng lực can thiệp và giám sát của con người như một cơ chế bảo vệ nhằm duy trì quyền chủ động và trách nhiệm giải trình.
Giám sát nên tập trung vào điểm quyết định, không phải mọi thao tác
Khác biệt quan trọng nhất là giữa thao tác có thể tự động hóa và phán đoán cần chịu trách nhiệm.
Một hệ thống có thể tự động thực hiện hàng trăm truy vấn tìm kiếm, đọc hàng nghìn đoạn văn bản hoặc chạy nhiều phép phân tích. Nếu con người phải duyệt từng hành động như vậy, hệ thống chỉ đang chuyển công việc thủ công sang một giao diện khác. Giá trị của giám sát xuất hiện khi con người kiểm soát những quyết định có ảnh hưởng lớn đến kết quả cuối cùng.
Một điểm kiểm soát nên được ưu tiên khi có ít nhất một trong các đặc điểm sau:
· Quyết định có thể thay đổi câu hỏi hoặc phạm vi nghiên cứu
· Sai sót ở bước này có khả năng lan truyền sang nhiều bước phía sau
· Kết quả phụ thuộc vào phán đoán thay vì một quy tắc kiểm tra đơn giản
· Hệ thống khó tự nhận biết khi chính nó đang sai
· Quyết định liên quan đến bằng chứng không chắc chắn, mâu thuẫn hoặc thiếu dữ liệu
· Kết quả có hậu quả đủ lớn để cần một chủ thể chịu trách nhiệm
Cách tiếp cận này cũng giúp phân biệt ba mức giám sát. Với các công việc ổn định và dễ kiểm tra, con người có thể chỉ theo dõi ngoại lệ. Với các quyết định quan trọng, hệ thống có thể chạy tự động nhưng phải dừng để con người phê duyệt. Với các bước có mức bất định hoặc hậu quả rất cao, con người nên trực tiếp tham gia quá trình lập luận.
Nghiên cứu AutoResearchClaw công bố năm 2026 cung cấp một ví dụ đáng chú ý: hệ thống thử bảy chế độ cộng tác người–AI và báo cáo rằng sự can thiệp có mục tiêu tại các điểm quyết định có đòn bẩy cao hoạt động tốt hơn cả hai cực là tự động hoàn toàn và giám sát từng bước. Kết quả này củng cố nguyên tắc rằng chất lượng của điểm can thiệp quan trọng hơn số lượng lần can thiệp.
Con người phải khóa câu hỏi, mục tiêu và tiêu chí thành công
Một workflow nghiên cứu có thể tối ưu rất tốt cho một mục tiêu được giao nhưng vẫn thất bại nếu mục tiêu ban đầu sai.
Đây là lý do lớp giám sát đầu tiên phải xuất hiện trước khi hệ thống bắt đầu nghiên cứu. Con người cần xác định vấn đề, phạm vi, giả định và tiêu chí để biết khi nào một câu trả lời được xem là đủ tốt.
Ví dụ, yêu cầu “tìm phương pháp hiệu quả nhất” chưa đủ chặt chẽ. “Hiệu quả” có thể chỉ tốc độ, độ chính xác, chi phí, khả năng tổng quát hóa hoặc mức độ an toàn. Nếu tiêu chí này không được cố định, một agent có thể thu thập bằng chứng đúng nhưng cuối cùng lại giải quyết một câu hỏi khác với câu hỏi mà người dùng thực sự quan tâm.
Giám sát ở giai đoạn này nên kiểm tra ba yếu tố.
Câu hỏi có đủ xác định để nghiên cứu hay chưa?
Workflow phải biết đối tượng, phạm vi và điều cần kết luận. Những thuật ngữ mơ hồ cần được chuyển thành tiêu chí có thể kiểm tra trước khi agent bắt đầu tối ưu chúng.
Điều gì được xem là bằng chứng đủ mạnh?
Một nghiên cứu có thể yêu cầu thử nghiệm thực nghiệm, nghiên cứu có đối chứng hoặc nguồn sơ cấp. Một nghiên cứu khác chỉ cần tổng hợp tài liệu. Hệ thống không nên tự thay đổi chuẩn bằng chứng chỉ vì nguồn tốt hơn khó tìm.
Khi nào workflow phải thừa nhận chưa đủ dữ liệu?
“Không đủ bằng chứng để kết luận” phải là một trạng thái đầu ra hợp lệ. Nếu hệ thống bị ép phải luôn tạo một câu trả lời hoàn chỉnh, nó có động lực biến khoảng trống dữ liệu thành suy luận.
Đây là một trong những chức năng mà tự động hóa khó thay thế hoàn toàn: con người quyết định nghiên cứu đang cố biết điều gì và tiêu chuẩn nào khiến một kết luận đáng được tin.
Kiểm soát nguồn và chuỗi bằng chứng quan trọng hơn kiểm tra văn phong đầu ra
Một báo cáo có thể rõ ràng, mạch lạc và vẫn sai.
Vì vậy, kiểm tra cuối cùng chỉ bằng cách đọc câu trả lời là một dạng giám sát yếu. Người giám sát cần có khả năng lần ngược từ từng kết luận quan trọng về nguồn, dữ liệu hoặc phép phân tích tạo ra kết luận đó.
Một workflow đáng tin cậy nên duy trì chuỗi:
Claim → Evidence → Source → Transformation → Conclusion
Khi một mắt xích không thể truy xuất, con người không thể phân biệt một kết luận dựa trên bằng chứng với một kết luận được hệ thống tạo ra vì nó “có vẻ hợp lý”.
Nguồn phải được đánh giá theo vai trò chứ không chỉ theo độ liên quan
Một tài liệu phù hợp về từ khóa chưa chắc đủ mạnh để chứng minh một claim. Người giám sát cần kiểm tra ít nhất nguồn đó là sơ cấp hay thứ cấp, dữ liệu có trực tiếp trả lời câu hỏi không, thời điểm có còn phù hợp không và phương pháp nghiên cứu có hỗ trợ cách diễn giải đang được sử dụng không.
Tổng hợp nhiều nguồn không tự động tạo ra đồng thuận
Mười trang web lặp lại cùng một tuyên bố không tương đương với mười bằng chứng độc lập. Workflow cần nhận biết quan hệ phụ thuộc giữa các nguồn và ưu tiên nguồn gốc của claim.
Trích dẫn đúng vẫn có thể dẫn đến kết luận sai
Agent có thể lấy dữ liệu chính xác nhưng tổng quát hóa vượt phạm vi nghiên cứu, bỏ qua điều kiện thí nghiệm hoặc ghép các bằng chứng không tương thích. Vì thế con người phải giám sát liên kết giữa bằng chứng và kết luận, không chỉ xác minh rằng tài liệu thực sự tồn tại.
Độ khó của bước này vẫn rất đáng kể. AutoResearchBench năm 2026 đánh giá các agent trên nhiệm vụ tìm kiếm tài liệu khoa học phức tạp và báo cáo ngay cả các mô hình mạnh nhất trong thử nghiệm chỉ đạt 9,39% accuracy ở bài Deep Research và 9,31% IoU ở bài Wide Research; nhiều baseline khác thấp hơn 5%. Điều đó cho thấy khả năng tìm được tập bằng chứng phù hợp trong nhiệm vụ nghiên cứu mở vẫn chưa thể được coi là một bước đã giải quyết xong.
Con người cần can thiệp mạnh ở giả thuyết, suy luận và diễn giải
Các bước dễ tự động hóa nhất thường là những bước có thể kiểm tra bằng quy tắc rõ ràng. Những bước khó hơn nằm ở nơi phải lựa chọn giữa nhiều cách giải thích hợp lý.
Trong nghiên cứu, ba điểm đặc biệt nhạy cảm là hình thành giả thuyết, lựa chọn cách kiểm chứng và diễn giải kết quả.
Một agent có thể tìm được một tương quan nhưng không có nghĩa tương quan đó chứng minh quan hệ nhân quả. Nó có thể tìm được kết quả có ý nghĩa thống kê nhưng điều đó không tự động cho thấy hiệu ứng có ý nghĩa thực tiễn. Nó cũng có thể chọn một giả thuyết phù hợp với dữ liệu đã tìm được mà không nhận ra rằng giả thuyết cạnh tranh chưa được kiểm tra đầy đủ.
Giám sát con người ở đây cần đặt các câu hỏi phản biện:
· Có cách giải thích cạnh tranh nào phù hợp với cùng dữ liệu không
· Kết luận có mạnh hơn mức mà thiết kế nghiên cứu cho phép không
· Có biến gây nhiễu hoặc điều kiện biên nào bị bỏ qua không
· Hệ thống đã chủ động tìm bằng chứng phản bác giả thuyết của chính nó chưa
· Kết quả có tái lập hoặc kiểm chứng độc lập được không
· Phần nào là quan sát, phần nào là suy luận và phần nào chỉ là giả thuyết
Các benchmark gần đây cho thấy chính những nhiệm vụ mở này vẫn là điểm yếu. SciAgentArena, với khoảng 200 nhiệm vụ nghiên cứu khoa học, cho thấy các agent có thể đóng góp tốt hơn khi workflow phân tích được xác định rõ và tiêu chí đánh giá cụ thể, nhưng hiệu suất trở nên không đồng đều khi cần tự khám phá, tạo insight mới hoặc giải quyết câu hỏi nghiên cứu mở.
Do đó, càng đi từ thực thi sang phán đoán khoa học, mức độ giám sát cần thiết càng cao.
Workflow phải có ngưỡng dừng, quyền phủ quyết và cơ chế chuyển cấp
Giám sát chỉ có ý nghĩa nếu người giám sát có thể thay đổi hành vi của hệ thống.
Một dashboard cho phép con người quan sát nhưng không thể dừng agent, sửa mục tiêu hoặc loại bỏ một kết luận không tạo ra quyền kiểm soát thực chất. Đây là khác biệt giữa human-in-the-loop có quyền quyết định và một con người chỉ hiện diện để hợp thức hóa kết quả tự động.
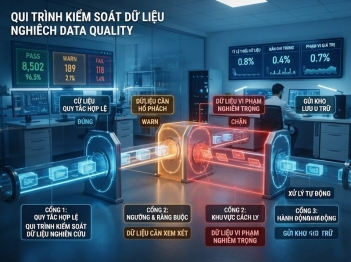
Workflow nên định nghĩa trước những tình huống buộc phải chuyển quyền quyết định sang con người.
Ví dụ, hệ thống có thể tự tiếp tục khi nhiều nguồn độc lập cùng hỗ trợ một claim và không phát hiện mâu thuẫn đáng kể. Nhưng nó nên dừng hoặc chuyển cấp khi xuất hiện bằng chứng trái chiều, nguồn sơ cấp không thể truy cập, mức độ tự tin giảm dưới ngưỡng đã đặt, kết quả phân tích không tái lập hoặc một bước thực thi tạo ra dữ liệu khác thường.
Điểm quan trọng là ngưỡng dừng phải được thiết kế trước khi nhìn thấy kết quả. Nếu con người chỉ quyết định có kiểm tra hay không sau khi thấy một kết luận hấp dẫn, chính quá trình giám sát có thể bị confirmation bias chi phối.
Người giám sát cũng phải có quyền thực tế để:
· Yêu cầu agent tìm bằng chứng phản chứng
· Yêu cầu chạy lại một phép phân tích
· Loại bỏ nguồn không đạt chuẩn
· Thu hẹp hoặc sửa câu hỏi nghiên cứu
· Hủy một nhánh suy luận
· Từ chối kết luận cuối cùng
· Chuyển nhiệm vụ sang đánh giá chuyên môn sâu hơn
OECD cảnh báo rằng một thách thức của human-in-the-loop là tránh biến con người thành người chỉ “đóng dấu” cho quyết định tự động. Vì vậy, quyền can thiệp phải đi kèm đủ thông tin và đủ thẩm quyền để tạo ra khác biệt thực sự.
Giám sát phải kiểm tra quy trình, không chỉ sản phẩm cuối
Nếu chỉ đánh giá bản báo cáo cuối cùng, nhiều lỗi quan trọng đã trở nên khó phát hiện.
Một kết luận có thể đúng vì may mắn dù chuỗi suy luận sai. Ngược lại, một kết quả không xác định có thể là đầu ra đúng của một workflow nghiêm ngặt. Vì thế chất lượng nghiên cứu tự động cần được đánh giá cả ở process level lẫn output level.
Tại cấp quy trình, con người cần có audit trail cho biết agent đã tìm gì, bỏ qua gì, thay đổi giả thuyết khi nào, chạy công cụ nào và bằng chứng nào dẫn tới từng claim. Với những workflow quan trọng, khả năng tái lập một nhánh nghiên cứu có giá trị hơn một bản tóm tắt lịch sử hành động quá ngắn để kiểm toán.
Tại cấp kết quả, hệ thống nên được đánh giá bằng các tiêu chí có thể quan sát thay vì cảm giác “báo cáo trông tốt”. Tùy loại nghiên cứu, các tiêu chí có thể gồm tỷ lệ claim truy xuất được về nguồn, số claim quan trọng được kiểm chứng độc lập, tỷ lệ lỗi trích dẫn, khả năng tái lập phân tích hoặc mức độ bao phủ bằng chứng phản chứng.
NIST AI RMF nhấn mạnh việc xác định rõ trách nhiệm trong cấu hình người–AI, còn OECD đặt human oversight trong bối cảnh rộng hơn của accountability. Điều này dẫn đến một nguyên tắc vận hành quan trọng: nếu sau một kết luận sai không thể xác định ai có trách nhiệm kiểm tra và ai có quyền từ chối kết quả, workflow chưa có một cơ chế giám sát hoàn chỉnh.
Mức giám sát nên thay đổi theo rủi ro và khả năng kiểm chứng
Không có một tỷ lệ “bao nhiêu phần trăm công việc phải do con người làm” phù hợp cho mọi workflow nghiên cứu.
Một nhiệm vụ thu thập metadata từ nguồn có cấu trúc có thể chạy gần như hoàn toàn tự động nếu dữ liệu đầu ra dễ kiểm tra. Một phân tích dùng để định hướng thí nghiệm tốn kém cần checkpoint nghiêm ngặt hơn. Một kết luận có ảnh hưởng tới sức khỏe, an toàn, quyền lợi hoặc quyết định có hậu quả lớn đòi hỏi mức kiểm soát cao hơn nữa.
Có thể phân bổ giám sát dựa trên hai biến: hậu quả nếu sai và khả năng phát hiện sai tự động.
Khi hậu quả thấp và lỗi dễ phát hiện, automation có thể cao. Khi hậu quả tăng hoặc lỗi khó nhận biết, quyền tự chủ của hệ thống nên giảm. Trường hợp rủi ro cao nhất là một kết quả rất thuyết phục nhưng sai theo cách không thể được phát hiện bằng các kiểm tra tự động thông thường; đây chính là nơi phán đoán chuyên môn của con người có giá trị lớn nhất.
Điều này cũng giải thích vì sao “human-in-the-loop” không nên được hiểu đơn giản là thêm một nút Approve. Một cơ chế giám sát có chất lượng phải trả lời được bốn câu hỏi:
1. Con người kiểm tra điều gì? — Các quyết định có ảnh hưởng lớn, không phải mọi thao tác
2. Khi nào phải kiểm tra? — Khi vượt ngưỡng rủi ro, bất định hoặc mâu thuẫn
3. Con người được nhìn thấy gì? — Bằng chứng, nguồn, chuỗi suy luận và dấu vết thực thi cần thiết để đánh giá
4. Con người có quyền làm gì? — Dừng, sửa, yêu cầu kiểm chứng, phủ quyết hoặc chuyển cấp
Khi bốn thành phần này được định nghĩa rõ, tự động hóa và giám sát không còn là hai mục tiêu đối nghịch. Automation xử lý khối lượng, tốc độ và các thao tác lặp lại; con người tập trung nguồn lực vào những quyết định đòi hỏi phán đoán, trách nhiệm và khả năng nhận ra khi một workflow đang giải quyết sai vấn đề.
Vai trò cốt lõi của con người trong workflow nghiên cứu tự động không phải là làm lại công việc của hệ thống. Con người cần giữ quyền kiểm soát mục tiêu nghiên cứu, chuẩn bằng chứng, các bước suy luận có độ bất định cao, điều kiện dừng và quyết định chấp nhận kết luận cuối cùng.
Thiết kế tốt nhất vì thế không phải “human kiểm tra mọi thứ” cũng không phải “agent tự làm mọi thứ”. Đó là một workflow phân bổ quyền tự chủ theo rủi ro: máy thực hiện những phần có thể tự động hóa và kiểm chứng; con người xuất hiện ở các điểm mà một sai lầm có thể thay đổi ý nghĩa của toàn bộ nghiên cứu. Khi giám sát được đặt đúng điểm, nó vừa bảo toàn lợi ích của tự động hóa vừa duy trì thứ mà hệ thống tự động chưa thể tự cấp cho mình: chuẩn mực nhận thức, quyền phán quyết và trách nhiệm đối với kết luận.

GỬI Ý KIẾN BÌNH LUẬN

