Cách tự động hóa luồng dữ liệu nghiên cứu
Mục lục
- Bản chất của tự động hóa luồng dữ liệu nghiên cứu
- Thiết kế cấu trúc dữ liệu trung gian để duy trì ngữ cảnh
- Xây dựng pipeline chuyển dữ liệu giữa các bước nghiên cứu
- Sử dụng trạng thái nghiên cứu để kiểm soát tính nhất quán
- Kiểm tra và xác thực dữ liệu trước khi chuyển bước
- Kết hợp tự động hóa với cơ chế truy xuất nguồn gốc dữ liệu
- Những giới hạn cần kiểm soát khi tự động hóa luồng dữ liệu nghiên cứu
- Cách triển khai tự động hóa luồng dữ liệu nghiên cứu hiệu quả
Tự động hóa luồng dữ liệu nghiên cứu giúp chuyển giao thông tin giữa các giai đoạn phân tích, giảm sai lệch, duy trì ngữ cảnh và nâng cao khả năng tái sử dụng kết quả nghiên cứu
Trong một quy trình nghiên cứu, dữ liệu thường không xuất hiện ở một bước duy nhất mà được tạo ra, xử lý và biến đổi liên tục qua nhiều giai đoạn. Một kết quả tìm kiếm có thể trở thành dữ liệu phân tích, dữ liệu phân tích có thể trở thành giả thuyết, và giả thuyết có thể tiếp tục được kiểm chứng bằng bằng chứng mới.
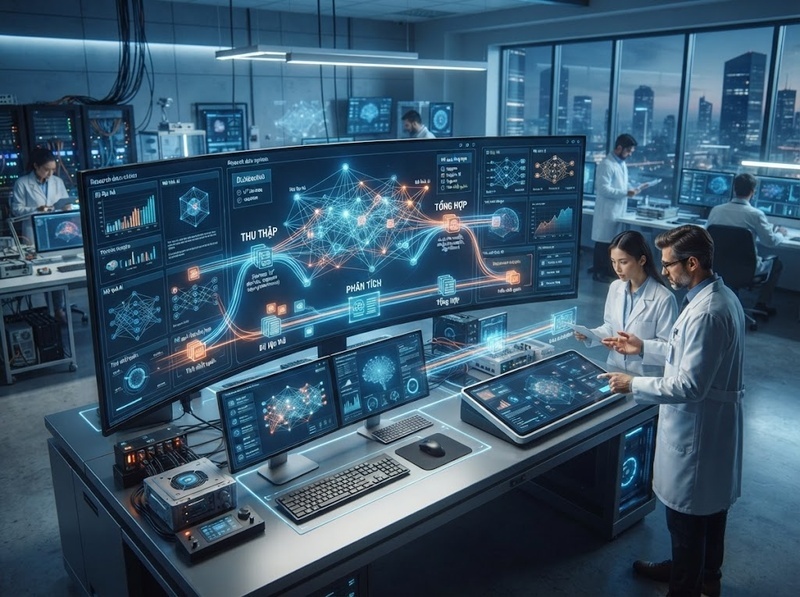
Vấn đề lớn nhất không nằm ở việc thu thập dữ liệu mà nằm ở khả năng chuyển dữ liệu giữa các bước mà vẫn giữ được ý nghĩa ban đầu. Nếu quá trình chuyển giao phụ thuộc vào thao tác thủ công, thông tin dễ bị mất ngữ cảnh, thay đổi cách diễn giải hoặc tạo ra các phiên bản dữ liệu không đồng nhất.
Tự động hóa luồng dữ liệu nghiên cứu giải quyết vấn đề này bằng cách thiết kế một hệ thống trong đó dữ liệu được truyền qua từng bước theo quy tắc định trước, có cấu trúc rõ ràng và có khả năng kiểm tra tính nhất quán.
Bản chất của tự động hóa luồng dữ liệu nghiên cứu
Tự động hóa luồng dữ liệu nghiên cứu là việc xây dựng cơ chế để dữ liệu được di chuyển, xử lý và cập nhật tự động giữa các giai đoạn nghiên cứu mà không cần lặp lại thao tác nhập liệu hoặc chuyển đổi thủ công.
Một luồng dữ liệu nghiên cứu tự động thường bao gồm:
· Điểm thu thập dữ liệu đầu vào
· Quy tắc chuẩn hóa dữ liệu
· Cơ chế truyền dữ liệu giữa các bước
· Hệ thống lưu trữ trạng thái nghiên cứu
· Cơ chế kiểm tra và xác thực dữ liệu
Điểm quan trọng của tự động hóa không chỉ là tốc độ xử lý mà là khả năng duy trì tính liên tục của tri thức. Mỗi bước sau phải hiểu được dữ liệu được tạo ra từ bước trước với đầy đủ bối cảnh cần thiết.
Thiết kế cấu trúc dữ liệu trung gian để duy trì ngữ cảnh
Một trong những nguyên nhân khiến luồng dữ liệu nghiên cứu mất nhất quán là việc truyền dữ liệu dưới dạng thông tin rời rạc.
Ví dụ, thay vì chỉ chuyển một kết quả nghiên cứu:
"Phân tích cho thấy phương pháp A hiệu quả"
hệ thống nên lưu cả cấu trúc:
· Câu hỏi nghiên cứu ban đầu
· Nguồn dữ liệu sử dụng
· Phương pháp phân tích
· Điều kiện áp dụng
· Kết quả thu được
· Giới hạn của kết luận
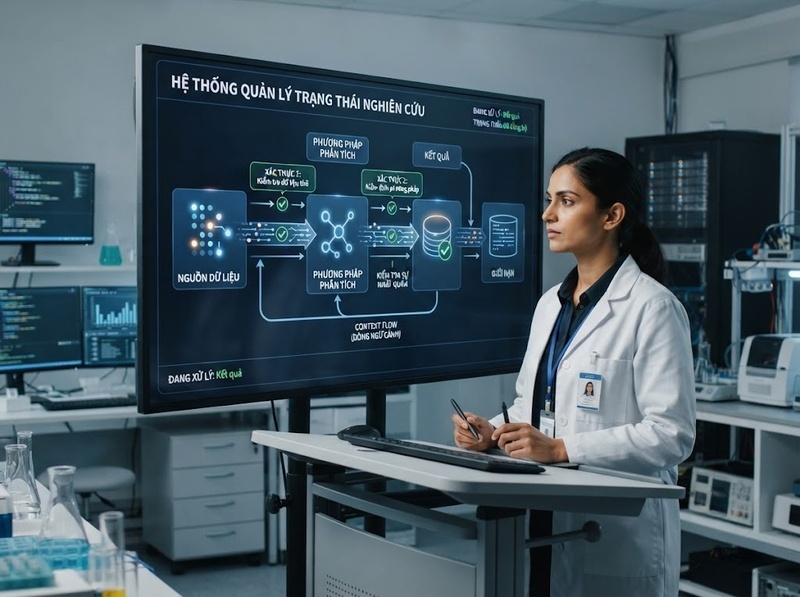
Cấu trúc dữ liệu trung gian giúp bước tiếp theo không chỉ nhận biết kết quả mà còn hiểu được cách kết quả đó được hình thành.
Điều này đặc biệt quan trọng trong các quy trình nghiên cứu nhiều tầng, nơi một quyết định ở giai đoạn sau phụ thuộc vào nhiều giả định từ giai đoạn trước.
Xây dựng pipeline chuyển dữ liệu giữa các bước nghiên cứu
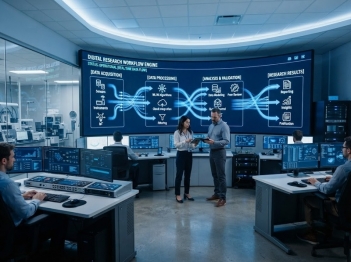
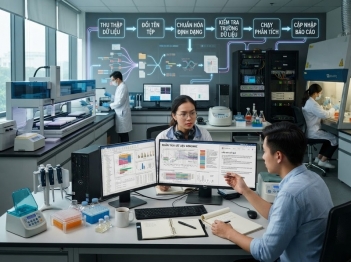
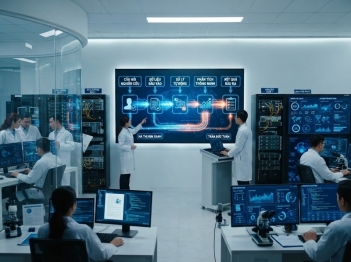
Một pipeline nghiên cứu tự động hoạt động như một chuỗi xử lý liên tục.
Luồng cơ bản có thể gồm:
Thu thập dữ liệu
↓
Chuẩn hóa dữ liệu
↓
Phân tích dữ liệu
↓
Tạo kết luận trung gian
↓
Kiểm chứng bằng bằng chứng
↓
Lưu trữ kết quả cuối cùng
Mỗi bước cần xác định rõ:
· Dữ liệu đầu vào là gì
· Quy trình xử lý nào được áp dụng
· Dữ liệu đầu ra có cấu trúc ra sao
· Điều kiện nào cho phép chuyển sang bước tiếp theo
Khi các quy tắc này được xác định trước, hệ thống có thể tự động truyền dữ liệu mà không làm thay đổi logic nghiên cứu.
Sử dụng trạng thái nghiên cứu để kiểm soát tính nhất quán
Dữ liệu nghiên cứu không chỉ là tập hợp thông tin mà còn bao gồm trạng thái của quá trình nghiên cứu.
Một hệ thống tự động hóa hiệu quả cần lưu được:
· Bước nghiên cứu hiện tại
· Dữ liệu đã hoàn thành
· Giả định đang sử dụng
· Quyết định đã đưa ra
· Các vấn đề chưa được giải quyết
Cơ chế trạng thái giúp tránh tình trạng bước sau phải tái tạo lại toàn bộ quá trình suy luận từ đầu.
Ví dụ, khi chuyển từ giai đoạn khám phá dữ liệu sang giai đoạn xây dựng báo cáo, hệ thống có thể tự động mang theo:
· Mục tiêu nghiên cứu
· Phạm vi phân tích
· Các phát hiện quan trọng
· Các giới hạn cần lưu ý
Nhờ đó, kết quả cuối cùng duy trì được sự liên kết với toàn bộ quá trình nghiên cứu.
Kiểm tra và xác thực dữ liệu trước khi chuyển bước
Tự động hóa không đồng nghĩa với việc chuyển dữ liệu một cách máy móc.
Mỗi bước chuyển giao cần có cơ chế kiểm tra:
· Dữ liệu có đầy đủ trường thông tin cần thiết không
· Định dạng dữ liệu có phù hợp không
· Kết luận có dựa trên dữ liệu hợp lệ không
· Có thay đổi ý nghĩa trong quá trình chuyển đổi không
Một quy trình nghiên cứu tự động tốt cần có các điểm kiểm soát để phát hiện lỗi trước khi dữ liệu tiếp tục đi sâu vào pipeline.
Nếu không có bước xác thực, lỗi nhỏ ở giai đoạn đầu có thể được khuếch đại thành sai lệch lớn ở kết quả cuối cùng.
Kết hợp tự động hóa với cơ chế truy xuất nguồn gốc dữ liệu
Một yêu cầu quan trọng của nghiên cứu chuyên sâu là khả năng truy xuất nguồn gốc.
Mỗi dữ liệu hoặc kết luận nên có liên kết với:
· Nguồn tạo ra dữ liệu
· Thời điểm cập nhật
· Quy trình xử lý
· Phiên bản thay đổi
· Người hoặc hệ thống tạo ra thay đổi
Cơ chế này giúp đánh giá lại kết quả khi cần thiết và bảo đảm rằng các bước nghiên cứu có thể được kiểm chứng.
Truy xuất nguồn gốc cũng giúp giảm rủi ro khi nhiều người hoặc nhiều hệ thống cùng tham gia vào một quy trình nghiên cứu.
Những giới hạn cần kiểm soát khi tự động hóa luồng dữ liệu nghiên cứu
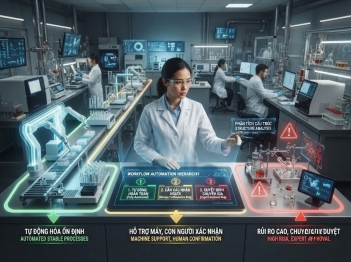
Tự động hóa có thể cải thiện tính nhất quán nhưng không thay thế hoàn toàn quá trình đánh giá tri thức.
Một số giới hạn cần lưu ý:
· Dữ liệu đầu vào sai vẫn tạo ra kết quả sai
· Quy tắc tự động hóa không phù hợp có thể làm sai lệch quy trình
· Hệ thống có thể duy trì tính nhất quán về hình thức nhưng không bảo đảm tính đúng đắn về nội dung
· Các quyết định nghiên cứu phức tạp vẫn cần đánh giá của con người
Vì vậy, tự động hóa hiệu quả cần kết hợp giữa quy trình máy móc và cơ chế kiểm duyệt chuyên môn.
Cách triển khai tự động hóa luồng dữ liệu nghiên cứu hiệu quả
Một quy trình triển khai thực tế có thể bắt đầu từ việc xác định các điểm chuyển giao dữ liệu quan trọng.
Các bước chính gồm:
· Xác định toàn bộ giai đoạn trong quy trình nghiên cứu
· Chuẩn hóa cấu trúc dữ liệu giữa các giai đoạn
· Xây dựng quy tắc truyền dữ liệu
· Thiết lập cơ chế lưu trạng thái
· Thêm bước kiểm tra trước mỗi lần chuyển đổi
· Theo dõi lịch sử thay đổi dữ liệu
Mục tiêu cuối cùng không phải là loại bỏ hoàn toàn con người khỏi quy trình mà là giảm các thao tác lặp lại, giảm sai sót và giúp nhà nghiên cứu tập trung vào các quyết định có giá trị cao hơn.
Tự động hóa luồng dữ liệu nghiên cứu hiệu quả cần dựa trên ba yếu tố chính: cấu trúc dữ liệu rõ ràng, quy trình chuyển giao có kiểm soát và khả năng duy trì ngữ cảnh xuyên suốt. Khi các yếu tố này được thiết kế đúng, dữ liệu có thể di chuyển giữa các bước nghiên cứu mà vẫn giữ được tính nhất quán, khả năng kiểm chứng và giá trị phân tích.
Hỏi đáp về Tự động hóa luồng dữ liệu nghiên cứu
Tự động hóa luồng dữ liệu nghiên cứu có thay thế hoàn toàn quy trình thủ công không?
Không. Tự động hóa chủ yếu thay thế các thao tác lặp lại như chuyển đổi, đồng bộ và kiểm tra dữ liệu cơ bản. Các quyết định nghiên cứu quan trọng vẫn cần đánh giá chuyên môn.
Vì sao dữ liệu nghiên cứu thường mất nhất quán khi chuyển giữa các bước?
Nguyên nhân phổ biến là dữ liệu không được chuẩn hóa, thiếu thông tin ngữ cảnh hoặc không có cơ chế quản lý trạng thái nghiên cứu.
Yếu tố quan trọng nhất khi xây dựng hệ thống tự động hóa dữ liệu nghiên cứu là gì?
Yếu tố quan trọng nhất là thiết kế cấu trúc dữ liệu trung gian để mỗi bước tiếp theo có thể hiểu đúng dữ liệu được tạo ra từ bước trước.

GỬI Ý KIẾN BÌNH LUẬN

