
Những tiêu chí tự động hóa nghiên cứu cần xem xét
Mục lục
- Quy trình có đủ ổn định và chuẩn hóa để tự động hóa không?
- Đầu vào, quy tắc và đầu ra có thể đo lường được đến mức nào?
- Sai sót có thể phát hiện, sửa chữa và giới hạn hậu quả không?
- Lợi ích tự động hóa có đủ lớn so với chi phí triển khai và duy trì?
- Quy trình cần bao nhiêu phán đoán chuyên môn và giám sát của con người?
- Kết quả có thể kiểm chứng, truy vết và duy trì theo thời gian không?
Một quy trình nghiên cứu chỉ phù hợp để tự động hóa khi đủ ổn định, có đầu vào và quy tắc kiểm soát rõ, mang lại lợi ích đủ lớn và vẫn duy trì được khả năng kiểm chứng, giám sát cũng như xử lý ngoại lệ. Bài viết phân tích các tiêu chí giúp xác định nên tự động hóa hoàn toàn, tự động hóa có giám sát hay tiếp tục giữ con người trong vòng lặp.
Không phải bước nghiên cứu nào có thể thực hiện bằng phần mềm hoặc AI cũng nên được tự động hóa. Khả năng kỹ thuật chỉ trả lời câu hỏi “có làm được hay không”, trong khi quyết định tự động hóa còn phụ thuộc vào độ ổn định của quy trình, chất lượng đầu vào, khả năng đo lường đầu ra, hậu quả của sai sót, lượng phán đoán chuyên môn cần thiết và chi phí kiểm soát hệ thống sau khi triển khai.
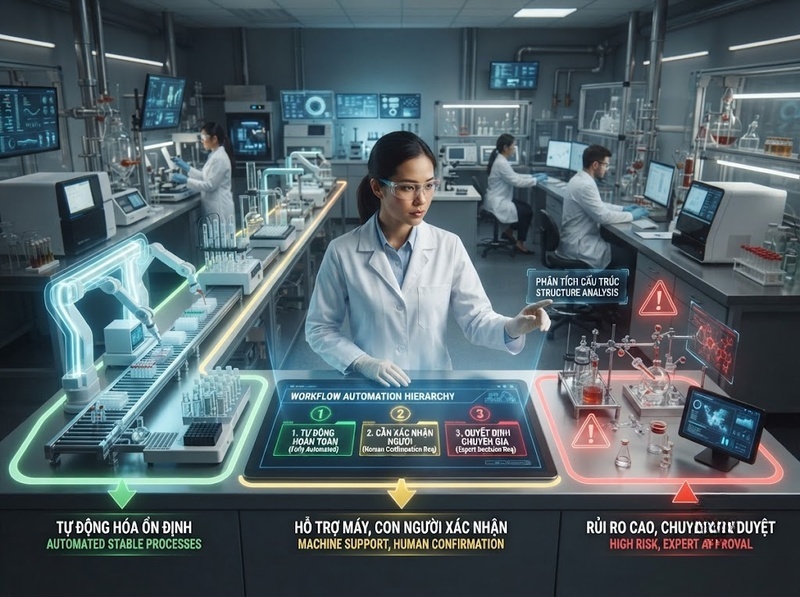
Vì vậy, đơn vị đánh giá phù hợp không nên là “một công cụ có làm được nhiệm vụ này không”, mà là một quy trình nghiên cứu cụ thể có đủ điều kiện để giao một phần hoặc toàn bộ hoạt động cho hệ thống tự động hay không. Một quy trình phù hợp thường có nhiệm vụ lặp lại tương đối ổn định, điều kiện đầu vào có thể xác định, kết quả có thể kiểm chứng và lỗi có thể phát hiện trước khi gây hậu quả nghiêm trọng. Ngược lại, quy trình phụ thuộc mạnh vào diễn giải bối cảnh, tiêu chí thay đổi thường xuyên hoặc quyết định khó đảo ngược thường cần mức giám sát của con người cao hơn.
Quy trình có đủ ổn định và chuẩn hóa để tự động hóa không?
Tiêu chí đầu tiên là độ ổn định của quy trình. Tự động hóa hoạt động tốt nhất khi có thể mô tả tương đối rõ một chuỗi: nhận đầu vào, thực hiện thao tác, áp dụng quy tắc, tạo đầu ra và kiểm tra kết quả.
Một công việc lặp đi lặp lại chưa chắc đã phù hợp để tự động hóa. Điều quan trọng hơn là mỗi lần thực hiện có dựa trên cùng một logic hay không. Nếu hai nhà nghiên cứu nhận cùng loại dữ liệu nhưng thường phải thay đổi phương pháp xử lý tùy từng trường hợp, phần khó nhất của nhiệm vụ thực chất nằm ở phán đoán chứ không phải thao tác.
Có thể kiểm tra độ ổn định bằng ba câu hỏi:
· Quy trình có thể mô tả thành các bước và điều kiện tương đối rõ ràng hay không
· Các ngoại lệ có phải trường hợp hiếm và có thể nhận diện hay không
· Tiêu chí hoàn thành có giữ nguyên đủ lâu để việc xây dựng tự động hóa có giá trị hay không
Ví dụ, chuẩn hóa tên trường dữ liệu, chuyển đổi định dạng tệp, loại bỏ bản ghi trùng hoặc chạy cùng một phép tính trên nhiều tập dữ liệu thường có cấu trúc ổn định. Ngược lại, xác định một phát hiện có thực sự mới về mặt khoa học hay lựa chọn cách diễn giải một kết quả mâu thuẫn thường phụ thuộc nhiều hơn vào bối cảnh và kiến thức chuyên môn.
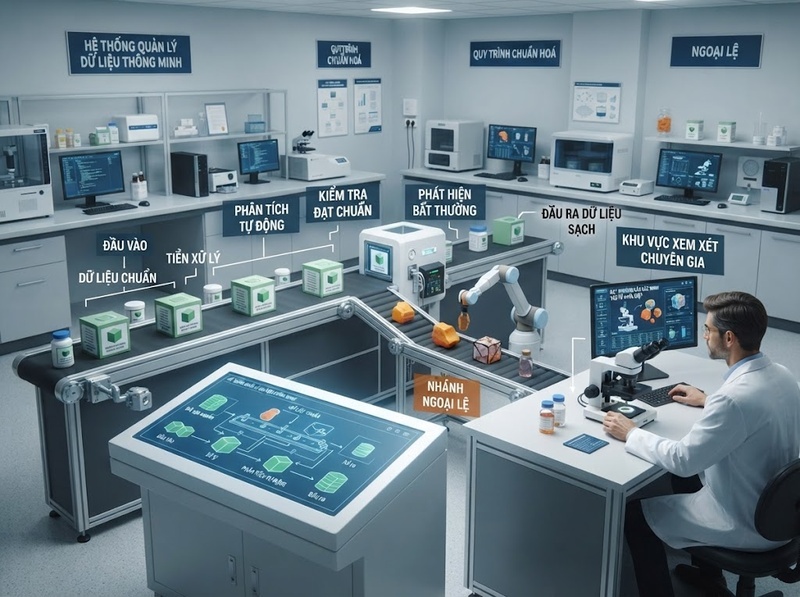
Điểm cần tránh là đồng nhất tính lặp lại với tính xác định. Một nhiệm vụ có thể xuất hiện hàng nghìn lần nhưng vẫn chứa nhiều trường hợp nhập nhằng. Khi đó, phương án phù hợp có thể là tự động hóa phần chuẩn hóa và sàng lọc ban đầu, sau đó chuyển các trường hợp không chắc chắn cho con người thay vì cố gắng tự động hóa toàn bộ.
Đầu vào, quy tắc và đầu ra có thể đo lường được đến mức nào?
Một quy trình chỉ có thể được kiểm soát tốt khi hệ thống biết mình đang nhận gì, phải làm gì và thế nào được xem là kết quả đạt yêu cầu.
Ba thành phần cần xem xét là độ nhất quán của đầu vào, mức độ biểu diễn được của quy tắc và khả năng đánh giá đầu ra.
Nếu dữ liệu đầu vào thường xuyên thiếu trường, thay đổi cấu trúc, sử dụng nhiều cách gọi cho cùng một khái niệm hoặc chứa thông tin mà máy khó phân biệt ngữ cảnh, phần tự động hóa phải dành thêm năng lực cho việc phát hiện và xử lý bất thường. Chi phí đó đôi khi lớn hơn lợi ích tiết kiệm từ nhiệm vụ chính.
Tương tự, một tiêu chí như “loại các tài liệu không liên quan” nghe có vẻ đơn giản nhưng chưa đủ để tự động hóa. Cần biết “liên quan” được xác định dựa trên biến nào, trường hợp biên xử lý ra sao và kết quả nào phải chuyển sang kiểm tra thủ công.
Khả năng đo lường đầu ra đặc biệt quan trọng. Với các hệ thống AI, NIST xem tính hợp lệ và độ tin cậy là nền tảng của một hệ thống đáng tin cậy, đồng thời nhấn mạnh việc kiểm thử và theo dõi để xác nhận hệ thống vẫn hoạt động như dự kiến.
Vì thế, trước khi tự động hóa nên xác định trước một bộ kiểm tra như độ chính xác, tỷ lệ bỏ sót, tỷ lệ trường hợp phải chuyển cho con người hoặc mức sai lệch chấp nhận được. Không có cách đo kết quả thì cũng không có cơ sở chắc chắn để biết tự động hóa đang tiết kiệm công sức hay chỉ chuyển lỗi sang một vị trí khó nhìn thấy hơn.
Sai sót có thể phát hiện, sửa chữa và giới hạn hậu quả không?
Không nên đánh giá một quy trình chỉ theo xác suất hệ thống làm đúng. Cần đánh giá đồng thời hậu quả khi hệ thống làm sai.
Hai nhiệm vụ có cùng tỷ lệ lỗi có thể có mức phù hợp với tự động hóa rất khác nhau. Nếu lỗi chỉ khiến một bản ghi phải xử lý lại, rủi ro tương đối thấp. Nếu lỗi có thể loại bỏ nhầm bằng chứng quan trọng, làm thay đổi tập dữ liệu phân tích hoặc tạo ra kết luận khoa học sai mà không được phát hiện, yêu cầu kiểm soát phải cao hơn nhiều.
Một cách thực tế là xem xét bốn yếu tố:
· Khả năng phát hiện lỗi trước khi đầu ra được sử dụng
· Khả năng đảo ngược hoặc chạy lại quy trình
· Mức độ lan truyền của lỗi sang các bước nghiên cứu tiếp theo
· Mức độ nghiêm trọng nếu lỗi không được phát hiện
Điểm này giải thích tại sao cùng một công nghệ nhưng có thể phù hợp ở bước này và chưa phù hợp ở bước khác. AI có thể hỗ trợ xếp hạng tài liệu để người nghiên cứu xem các tài liệu có khả năng liên quan trước, trong khi việc cho hệ thống tự loại hoàn toàn tài liệu mà không có cơ chế kiểm soát tạo ra rủi ro khác.
Trong tổng hợp bằng chứng, Cochrane hiện nhấn mạnh rằng AI và tự động hóa nên được sử dụng với giám sát của con người, đặc biệt khi công cụ đưa ra hoặc gợi ý những phán đoán ảnh hưởng đến quá trình tổng hợp bằng chứng. Điều này phản ánh một nguyên tắc rộng hơn: càng khó phát hiện và sửa hậu quả của một quyết định, mức tự chủ nên giao cho hệ thống càng phải được cân nhắc kỹ.
Lợi ích tự động hóa có đủ lớn so với chi phí triển khai và duy trì?
Một quy trình có thể tự động hóa về mặt kỹ thuật nhưng vẫn không đáng tự động hóa về mặt vận hành.
Lợi ích thường đến từ việc giảm thời gian thao tác, tăng thông lượng, giảm biến thiên do thực hiện thủ công hoặc cho phép xử lý khối lượng dữ liệu mà con người khó thực hiện ở cùng tốc độ. Tuy nhiên, lợi ích đó phải được so với toàn bộ chi phí vòng đời, không chỉ chi phí viết script hoặc mua công cụ ban đầu.
Chi phí thực tế còn gồm chuẩn hóa dữ liệu, tích hợp hệ thống, xây dựng tập kiểm thử, giám sát chất lượng, sửa lỗi, cập nhật khi nguồn dữ liệu thay đổi và xử lý các trường hợp ngoại lệ.
Do đó, tần suất và quy mô của nhiệm vụ là biến số quan trọng. Nếu một thao tác mất 20 phút nhưng chỉ diễn ra hai lần mỗi năm, xây dựng và duy trì một hệ thống tự động có thể không hợp lý. Nếu cùng thao tác được thực hiện trên hàng nghìn trường hợp mỗi tháng, ngay cả tự động hóa một phần cũng có thể tạo ra giá trị đáng kể.
Không nên vì vậy đặt một ngưỡng thời gian cố định áp dụng cho mọi quy trình. Quyết định phù hợp hơn là so sánh tổng công sức thủ công dự kiến với tổng công sức xây dựng, xác thực và duy trì tự động hóa trong một khoảng thời gian đủ dài.
Một chỉ báo hữu ích khác là tỷ lệ ngoại lệ. Khi phần lớn trường hợp đi theo một luồng chuẩn và chỉ một tỷ lệ nhỏ cần phán đoán, mô hình “tự động xử lý trường hợp chuẩn, chuyển ngoại lệ cho người” thường có hiệu quả hơn cả hai cực: hoàn toàn thủ công hoặc hoàn toàn tự động.
Quy trình cần bao nhiêu phán đoán chuyên môn và giám sát của con người?
Một trong những sai lầm phổ biến khi đánh giá tự động hóa là xem mọi nhiệm vụ như một tập hợp thao tác. Trong nghiên cứu, nhiều bước tạo giá trị chính bởi phán đoán chứ không phải bởi thao tác.
Phán đoán thường xuất hiện khi cần xác định ý nghĩa của bằng chứng, xử lý thông tin mâu thuẫn, đánh giá độ tin cậy của nguồn, lựa chọn giả thuyết đáng theo đuổi hoặc quyết định một ngoại lệ có làm thay đổi phương pháp nghiên cứu hay không.
Các nhiệm vụ như vậy không nhất thiết phải loại khỏi tự động hóa. Nhưng vai trò của hệ thống nên được thiết kế khác: tìm kiếm, tổng hợp ứng viên, phát hiện bất thường hoặc đề xuất lựa chọn; con người giữ quyền xác nhận những quyết định quan trọng.
NIST khuyến nghị các tổ chức không chỉ duy trì giám sát của con người mà còn đo lường và ghi lại mức độ giám sát đối với đầu ra của hệ thống AI. Trong nghiên cứu khoa học, các công trình gần đây về ứng dụng LLM cũng nhấn mạnh nhu cầu giám sát con người khi hệ thống tham gia sâu hơn vào quy trình nhằm duy trì tính nghiêm ngặt khoa học và sự phù hợp với mục tiêu nghiên cứu.
Điều này dẫn đến một cách phân loại hữu ích:
· Tự động hóa hoàn toàn phù hợp hơn với tác vụ ổn định, dễ kiểm chứng và có hậu quả lỗi thấp
· Tự động hóa có giám sát phù hợp với tác vụ mà hệ thống có thể xử lý phần lớn trường hợp nhưng vẫn tồn tại ngoại lệ hoặc quyết định quan trọng
· Hỗ trợ con người phù hợp với tác vụ giàu phán đoán, nơi hệ thống chủ yếu giảm tải việc tìm kiếm, chuẩn bị hoặc tổ chức thông tin
· Giữ thủ công hợp lý khi mục tiêu, tiêu chí hoặc bối cảnh thay đổi quá thường xuyên khiến việc tự động hóa khó kiểm soát
Mục tiêu vì thế không phải loại con người khỏi quy trình càng nhiều càng tốt. Mục tiêu là đặt con người ở những điểm mà phán đoán của họ tạo ra giá trị lớn nhất.
Kết quả có thể kiểm chứng, truy vết và duy trì theo thời gian không?
Một quy trình tự động hóa nghiên cứu không kết thúc khi hệ thống tạo ra kết quả. Nó còn phải cho phép người nghiên cứu trả lời được: dữ liệu nào đã được sử dụng, quy tắc hoặc phiên bản công cụ nào đã chạy, bước nào đã biến đổi dữ liệu và tại sao một đầu ra cụ thể xuất hiện.
Khả năng truy vết này ảnh hưởng trực tiếp tới khả năng kiểm tra và tái lập nghiên cứu. Một nghiên cứu quy mô lớn về mã nghiên cứu công bố trên Scientific Data cho thấy chất lượng thực thi và khả năng tái sử dụng mã là những vấn đề thực tế đối với tính tái lập của nghiên cứu. Tự động hóa có thể tăng tính nhất quán, nhưng chỉ khi quy trình, phiên bản, phụ thuộc và đầu ra trung gian được quản lý đủ rõ.
Vì vậy, trước khi tự động hóa cần xem hệ thống có hỗ trợ hay có thể bổ sung:
· Nhật ký thực thi và nguồn gốc dữ liệu
· Phiên bản của mã, mô hình, prompt hoặc quy tắc
· Lưu đầu ra trung gian cần thiết để kiểm tra
· Bộ dữ liệu hoặc trường hợp chuẩn để kiểm thử lại sau khi cập nhật
· Cơ chế phát hiện thay đổi ở nguồn dữ liệu hoặc môi trường vận hành
Với hệ thống AI, việc đánh giá một lần trước khi triển khai chưa đủ. NIST mô tả quản trị rủi ro theo các chức năng Govern, Map, Measure và Manage, trong đó hoạt động đo lường và quản lý tiếp tục sau khi hệ thống được đưa vào sử dụng.
Tiêu chí này tạo ra một ranh giới quan trọng: một tác vụ có thể tự động chạy nhưng chưa chắc đã sẵn sàng để trở thành một quy trình nghiên cứu tự động đáng tin cậy. Nếu không thể truy vết và kiểm chứng kết quả, tốc độ tăng lên nhưng khả năng bảo vệ kết luận khoa học có thể giảm xuống.
Một quy trình phù hợp để tự động hóa không được quyết định bởi một tiêu chí duy nhất. Sự phù hợp xuất hiện khi nhiều điều kiện cùng hội tụ: quy trình đủ ổn định, đầu vào và tiêu chí đánh giá có thể xác định, kết quả kiểm chứng được, sai sót có thể giới hạn, khối lượng công việc đủ lớn để tạo lợi ích và mức phán đoán cần thiết tương thích với cơ chế giám sát.
Do đó, câu hỏi hiệu quả nhất trước khi triển khai không phải là “có thể tự động hóa bao nhiêu phần trăm?”, mà là “phần nào của quy trình có logic ổn định và kiểm chứng được để giao cho máy, phần nào cần con người kiểm soát, và ở đâu một sai sót phải buộc hệ thống dừng hoặc chuyển quyền quyết định?”. Cách đánh giá này giúp tránh hai thái cực: tự động hóa quá ít nên không tạo giá trị, hoặc tự động hóa quá sâu khiến hiệu quả tăng nhưng độ tin cậy của nghiên cứu giảm.
Một quy trình có nhiều ngoại lệ có nên tự động hóa không?
Có thể, nhưng thường phù hợp với tự động hóa một phần hơn là tự động hóa hoàn toàn. Hệ thống có thể xử lý luồng chuẩn và chuyển các ngoại lệ đã nhận diện cho con người. Nếu ngoại lệ chiếm phần lớn công việc hoặc rất khó nhận biết, lợi ích tự động hóa sẽ giảm đáng kể.
Có cần tự động hóa toàn bộ quy trình nghiên cứu mới tạo ra giá trị không?
Không. Giá trị thường đến từ việc tự động hóa đúng điểm nghẽn như thu thập, chuẩn hóa, kiểm tra định dạng, chạy phân tích lặp lại hoặc chuẩn bị thông tin để chuyên gia ra quyết định. Việc giữ con người tại các điểm cần phán đoán không làm mô hình tự động hóa kém hiệu quả.
Khi nào nên dừng một dự án tự động hóa nghiên cứu?
Nên xem xét dừng hoặc thu hẹp phạm vi khi chi phí xử lý ngoại lệ, xác thực và bảo trì liên tục vượt lợi ích tiết kiệm; khi không xây dựng được tiêu chí đánh giá đầu ra đáng tin cậy; hoặc khi lỗi của hệ thống khó phát hiện nhưng có thể ảnh hưởng đáng kể tới kết luận nghiên cứu.

GỬI Ý KIẾN BÌNH LUẬN

