Cách tự động hóa kiểm tra dữ liệu nghiên cứu
Mục lục
- Chuyển tiêu chí chất lượng dữ liệu thành quy tắc có thể chạy tự động
- Dùng ngưỡng để biến kiểm tra thành quyết định vận hành
- Xây dựng các lớp kiểm tra từ schema đến bất thường thống kê
- Đặt các checkpoint kiểm tra tại đúng vị trí trong workflow nghiên cứu
- Tự động hóa phản ứng khi quy tắc hoặc ngưỡng bị vi phạm
- Hiệu chỉnh và kiểm thử hệ thống quy tắc trước khi cho chạy tự động
- Thiết kế một framework kiểm tra có thể duy trì và tái lập
Tự động hóa kiểm tra dữ liệu nghiên cứu hiệu quả bằng cách chuyển tiêu chí chất lượng thành quy tắc có thể thực thi, thiết lập ngưỡng cảnh báo và ngưỡng chặn, kiểm tra dữ liệu theo từng lớp, ghi lại lỗi và quyết định xử lý ngay trong workflow thay vì phụ thuộc vào kiểm tra thủ công.
Tự động hóa kiểm tra dữ liệu nghiên cứu không đơn giản là viết một tập lệnh phát hiện ô trống. Mục tiêu thực sự là biến các yêu cầu về tính hợp lệ, tính đầy đủ, tính nhất quán và mức độ bất thường thành những điều kiện mà hệ thống có thể tự đánh giá mỗi khi dữ liệu đi qua workflow.
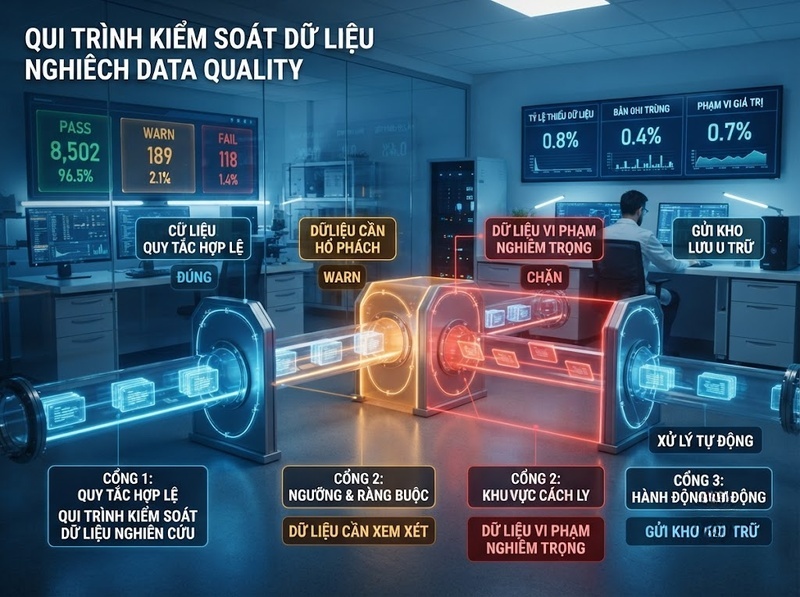
Một cơ chế kiểm tra tốt thường cần ba thành phần đi cùng nhau: quy tắc xác định điều gì được xem là sai, ngưỡng xác định mức sai nào cần hành động và logic xử lý xác định workflow phải làm gì khi vi phạm xảy ra.
Ví dụ, tỷ lệ giá trị thiếu 0,5% và 25% đều là “có dữ liệu thiếu”, nhưng ý nghĩa vận hành hoàn toàn khác nhau. Vì vậy, kiểm tra dạng đúng/sai thường chưa đủ. Workflow nghiên cứu cần phân biệt lỗi nghiêm trọng phải chặn dữ liệu, bất thường cần cảnh báo và sai lệch nhỏ có thể tiếp tục nhưng phải được ghi nhận.
Chuyển tiêu chí chất lượng dữ liệu thành quy tắc có thể chạy tự động
Bước nền tảng là biến những yêu cầu vốn được diễn đạt bằng ngôn ngữ như “dữ liệu phải đầy đủ”, “không được có giá trị vô lý” hay “các biến phải nhất quán” thành điều kiện định lượng hoặc logic cụ thể.
Một quy tắc nên trả lời được bốn câu hỏi:
1. Đối tượng nào được kiểm tra
2. Điều kiện nào được xem là hợp lệ
3. Vi phạm được đo bằng chỉ số nào
4. Vi phạm dẫn đến hành động nào
Ví dụ, thay vì quy định chung rằng “tuổi phải hợp lý”, có thể định nghĩa:
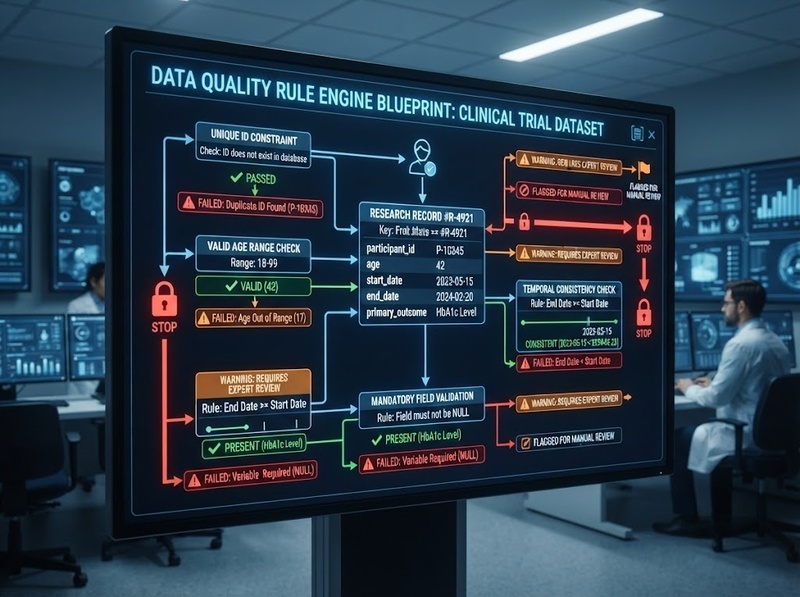
0 ≤ age ≤ 120
Thay vì “mã người tham gia không được trùng”, quy tắc trở thành:
duplicate_rate(participant_id) = 0
Với biến bắt buộc, điều kiện có thể là:
missing_rate(primary_outcome) ≤ threshold
Quy tắc cũng có thể kiểm tra quan hệ giữa nhiều trường. Chẳng hạn, nếu một bản ghi ghi nhận ngày kết thúc nghiên cứu trước ngày bắt đầu, từng trường riêng lẻ vẫn có thể mang giá trị hợp lệ nhưng quan hệ giữa chúng là bất khả thi:
end_date >= start_date
Đây là lý do kiểm tra dữ liệu nên được xây dựng thành nhiều lớp thay vì gom toàn bộ logic vào một bước duy nhất.
Phân biệt quy tắc cứng và quy tắc mềm
Không phải mọi vi phạm đều có cùng mức độ chắc chắn.
Quy tắc cứng áp dụng cho những điều kiện mà dữ liệu hợp lệ bắt buộc phải đáp ứng. Ví dụ:
· ID bắt buộc không được rỗng
· Khóa chính không được trùng
· Giá trị categorical chỉ được thuộc tập mã đã định nghĩa
· Ngày kết thúc không được sớm hơn ngày bắt đầu
· Kiểu dữ liệu phải đúng với schema
Vi phạm loại này thường đủ căn cứ để workflow dừng hoặc cách ly dữ liệu.
Quy tắc mềm dùng cho các trường hợp bất thường nhưng chưa chắc là lỗi. Ví dụ một giá trị cao hơn rất nhiều so với phần còn lại có thể là lỗi nhập liệu, nhưng cũng có thể là quan sát thực sự.
Quy tắc mềm vì thế phù hợp với trạng thái cảnh báo hoặc yêu cầu review hơn là tự động xóa bản ghi.
Sự phân biệt này đặc biệt quan trọng trong nghiên cứu: tự động hóa nên phát hiện và điều phối vấn đề, không nên biến mọi dấu hiệu bất thường thành quyết định loại bỏ dữ liệu.
Dùng ngưỡng để biến kiểm tra thành quyết định vận hành
Một quy tắc chỉ xác định “điều gì đang được đo”. Ngưỡng mới quyết định khi nào workflow phải phản ứng.
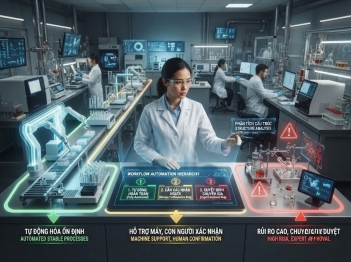
Thay vì dùng một ngưỡng duy nhất, có thể thiết kế ba vùng:
|
Trạng thái |
Ý nghĩa |
Hành động |
|
PASS |
Chỉ số nằm trong phạm vi chấp nhận |
Tiếp tục workflow |
|
WARN |
Có sai lệch đáng chú ý nhưng chưa đủ căn cứ dừng |
Ghi log, cảnh báo, yêu cầu review khi cần |
|
FAIL |
Vi phạm điều kiện nghiêm trọng |
Chặn bước tiếp theo hoặc cách ly dữ liệu |
Ví dụ với tỷ lệ thiếu của một trường quan trọng, một dự án có thể định nghĩa:
· PASS khi tỷ lệ thiếu ≤ 1%
· WARN khi > 1% và ≤ 5%
· FAIL khi > 5%
Các con số trên chỉ là ví dụ về cấu trúc ngưỡng, không phải ngưỡng chuẩn có thể áp dụng cho mọi nghiên cứu. Ngưỡng thực tế phải xuất phát từ thiết kế nghiên cứu, vai trò của biến, kế hoạch phân tích và mức sai lệch mà nhóm nghiên cứu chấp nhận.
Một biến dùng để mô tả bổ sung có thể chịu mức thiếu cao hơn biến kết cục chính. Vì vậy, áp dụng cùng một tỷ lệ cho toàn bộ dataset thường tạo ra cảm giác kiểm soát nhưng không phản ánh đúng rủi ro.
Không nên đặt ngưỡng chỉ dựa vào dữ liệu hiện tại
Nếu ngưỡng được chọn đơn giản vì “dataset lần này đang có mức đó”, hệ thống có nguy cơ hợp thức hóa chính dữ liệu đang cần kiểm tra.
Ngưỡng nên được xác định trước từ một hoặc nhiều căn cứ như:
· Protocol hoặc data management plan
· Định nghĩa biến và schema
· Yêu cầu của phương pháp phân tích
· Đặc điểm của thiết bị hoặc quy trình thu thập
· Dữ liệu lịch sử đã được xác nhận
· Mức rủi ro chấp nhận được của nghiên cứu
Khi chưa đủ căn cứ để đặt một ngưỡng cứng, lựa chọn an toàn hơn là dùng ngưỡng cảnh báo và chuyển trường hợp nghi vấn sang review thay vì tự động loại bỏ.
Xây dựng các lớp kiểm tra từ schema đến bất thường thống kê
Không nên bắt đầu bằng phát hiện outlier. Một workflow ổn định thường kiểm tra những lỗi xác định rõ nhất trước, sau đó mới tiến tới những kiểm tra phụ thuộc ngữ cảnh.
Kiểm tra cấu trúc và schema
Đây thường là lớp đầu tiên vì lỗi cấu trúc có thể khiến tất cả bước phía sau mất ý nghĩa.
Có thể kiểm tra:
· Tên cột bắt buộc
· Cột thừa hoặc thiếu
· Kiểu dữ liệu
· Định dạng ngày giờ
· Tập giá trị categorical
· Tính duy nhất của khóa
· Phiên bản schema
Nếu một pipeline kỳ vọng participant_id, visit_date và outcome_score nhưng file đầu vào thiếu participant_id, việc tiếp tục tính tỷ lệ thiếu hay thống kê phân bố không giải quyết được vấn đề căn bản.
Kiểm tra tính đầy đủ
Ở lớp này, workflow đo mức dữ liệu bị thiếu thay vì chỉ tìm từng ô trống.
Những metric hữu ích có thể gồm:
missing_rate = missing_count / total_rows
Có thể tính metric cho:
· Toàn dataset
· Từng biến
· Từng nhóm đối tượng
· Từng điểm nghiên cứu
· Từng thời điểm thu thập
Phân rã theo nhóm thường cung cấp nhiều thông tin hơn tỷ lệ tổng. Dataset chỉ thiếu 2% tổng thể có thể trông ổn, nhưng nếu phần thiếu tập trung gần như toàn bộ tại một site hoặc một giai đoạn thì nguyên nhân vận hành có thể rất đáng chú ý.
Kiểm tra phạm vi và tính hợp lệ
Mỗi biến có thể có một miền giá trị được phép.
Ví dụ:
score ∈ [0, 100]
hoặc:
treatment_group ∈ {"control", "A", "B"}
Các kiểm tra này phù hợp với tự động hóa vì điều kiện hợp lệ rõ ràng và có thể kiểm thử trực tiếp.
Kiểm tra tính nhất quán giữa các biến
Đây là lớp giúp phát hiện những bản ghi “đúng từng ô nhưng sai về logic”.
Ví dụ:
· Ngày follow-up phải bằng hoặc sau ngày enrollment
· Người được đánh dấu “không điều trị” không nên đồng thời có ngày bắt đầu điều trị
· Giá trị tổng phải phù hợp với các thành phần cấu thành nếu biến được tính theo công thức
· Một participant không được xuất hiện ở visit không tồn tại trong protocol
Các kiểm tra quan hệ thường tạo giá trị lớn vì nhiều lỗi dữ liệu không thể được phát hiện bằng range check riêng lẻ.
Kiểm tra phân bố và bất thường
Sau khi dữ liệu vượt qua các lớp cấu trúc và logic, workflow mới nên đánh giá các dấu hiệu bất thường như:
· Giá trị cực đoan
· Thay đổi phân bố bất thường
· Tỷ lệ một category tăng đột ngột
· Số lượng bản ghi giảm mạnh
· Một site có hành vi khác hẳn phần còn lại
Điểm quan trọng là outlier không đồng nghĩa với lỗi. Các kỹ thuật thống kê phát hiện quan sát hiếm chỉ tạo ra evidence để xem xét. Nếu không có quy tắc khoa học hoặc nghiệp vụ chứng minh giá trị đó bất khả thi, workflow nên gắn cờ thay vì tự động loại bỏ.
Đặt các checkpoint kiểm tra tại đúng vị trí trong workflow nghiên cứu
Kiểm tra dữ liệu hiệu quả nhất khi nó được chạy gần thời điểm lỗi được tạo ra.
Nếu toàn bộ validation chỉ được thực hiện trước phân tích cuối cùng, một lỗi xuất hiện từ bước thu thập có thể đã truyền qua nhiều quá trình chuyển đổi và trở nên khó truy nguyên.
Có thể đặt checkpoint theo chuỗi:
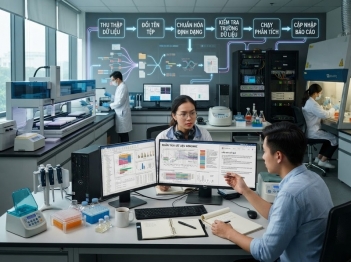
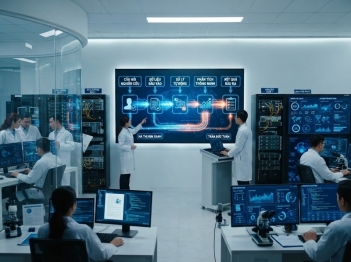
Raw data → Ingestion validation → Cleaning → Transformation validation → Dataset phân tích → Pre-analysis validation → Analysis
Mỗi checkpoint có nhiệm vụ khác nhau.
Ở lúc ingestion, trọng tâm là kiểm tra file, schema, khóa và dữ liệu đầu vào. Sau bước cleaning hoặc transformation, cần kiểm tra xem phép biến đổi có tạo thêm thiếu dữ liệu, làm thay đổi số bản ghi hoặc phá vỡ quan hệ hay không. Trước phân tích, validation tập trung vào những điều kiện mà mô hình hoặc phương pháp thống kê yêu cầu.
Dùng invariant để phát hiện lỗi do chính pipeline tạo ra
Một cách kiểm tra mạnh là định nghĩa những tính chất phải được giữ nguyên sau một phép biến đổi.
Ví dụ, nếu thao tác chỉ chuẩn hóa tên biến thì:
row_count_before = row_count_after
Nếu một bước join được kỳ vọng là quan hệ một-một, số bản ghi tăng mạnh sau join là dấu hiệu cần điều tra.
Nếu một phép tính tạo biến mới nhưng không được phép sửa dữ liệu gốc, có thể kiểm tra hash hoặc thống kê của các cột nguồn trước và sau bước xử lý.
Nhờ đó, validation không chỉ kiểm tra chất lượng của dữ liệu ban đầu mà còn kiểm tra tính đúng đắn của chính workflow.
Tự động hóa phản ứng khi quy tắc hoặc ngưỡng bị vi phạm
Một hệ thống kiểm tra chưa thực sự tự động nếu nó chỉ in ra danh sách lỗi rồi phụ thuộc hoàn toàn vào người vận hành quyết định bước tiếp theo.
Mỗi quy tắc nên có hành động tương ứng.
Một cấu trúc đơn giản có thể là:
rule → metric → threshold → status → action
Ví dụ:
duplicate participant_id → duplicate_count → > 0 → FAIL → stop pipeline
hoặc:
unusual distribution → drift metric → warning threshold → WARN → create review flag
Các hành động thường có thể chia thành bốn nhóm:
· Continue: dữ liệu đạt điều kiện, pipeline tiếp tục
· Log: ghi nhận sai lệch nhưng không cản trở bước sau
· Review: tạo cảnh báo hoặc danh sách bản ghi cần con người đánh giá
· Block/Quarantine: ngăn dữ liệu không đạt chuẩn đi vào phân tích tiếp theo
Ghi lại bằng chứng thay vì chỉ ghi “FAIL”
Log validation nên trả lời được:
· Quy tắc nào thất bại
· Dataset hoặc phiên bản nào được kiểm tra
· Thời điểm chạy
· Chỉ số đo được
· Ngưỡng áp dụng
· Số lượng và tỷ lệ bản ghi bị ảnh hưởng
· Bản ghi hoặc nhóm nào liên quan
· Phiên bản quy tắc
· Workflow đã thực hiện hành động gì
Ví dụ, thông báo:
missingness_check = FAIL
không đủ hữu ích để điều tra.
Thông tin tốt hơn là:
primary_outcome missing rate = 7.4%; fail threshold = 5%; affected rows = 148/2000; action = pipeline blocked
Cách ghi này biến validation log thành một phần của audit trail, đồng thời giúp nhóm nghiên cứu phân biệt lỗi dữ liệu mới với thay đổi do cập nhật rule.
Hiệu chỉnh và kiểm thử hệ thống quy tắc trước khi cho chạy tự động
Validation code cũng là code và có thể sai.
Một rule viết nhầm toán tử, một thay đổi schema chưa cập nhật hoặc một threshold đặt không phù hợp có thể khiến dữ liệu tốt bị chặn hoặc dữ liệu lỗi vượt qua kiểm soát.
Vì vậy, các rule quan trọng cần được kiểm thử bằng những trường hợp biết trước kết quả.
Ví dụ, với quy tắc:
age >= 18
test nên bao gồm ít nhất:
· age = 18 → PASS
· age = 17 → FAIL
· age = NULL → xử lý theo chính sách missing đã định nghĩa
Các giá trị sát biên đặc biệt quan trọng vì đây là nơi các lỗi như > thay vì >= thường xuất hiện.
Theo dõi cả false positive và false negative
Một hệ thống gắn cờ quá nhiều không nhất thiết là hệ thống tốt.
Nếu gần như mọi lần chạy đều phát hàng trăm cảnh báo nhưng phần lớn không có ý nghĩa, người dùng dễ hình thành “alert fatigue” và bắt đầu bỏ qua cảnh báo thực sự quan trọng.
Ngược lại, một hệ thống hiếm khi cảnh báo cũng chưa chắc đáng tin nếu rule quá lỏng.
Do đó, sau mỗi giai đoạn vận hành nên xem lại:
· Rule nào thường xuyên FAIL
· Bao nhiêu cảnh báo được xác nhận là vấn đề thật
· Rule nào không còn phù hợp sau khi protocol hoặc schema thay đổi
· Threshold nào tạo quá nhiều cảnh báo không hữu ích
· Có lỗi thực tế nào lọt qua validation hay không
Threshold vì vậy nên được quản lý phiên bản và hiệu chỉnh có kiểm soát, không chỉnh tùy tiện để làm cho pipeline “xanh”.
Thiết kế một framework kiểm tra có thể duy trì và tái lập
Khi số lượng rule tăng lên, đặt logic kiểm tra rải rác trong nhiều notebook hoặc script khiến workflow khó audit và khó tái sử dụng.
Một thiết kế bền vững hơn là tách ba thành phần.
Thứ nhất là cấu hình rule. Nơi này mô tả biến, điều kiện, threshold, severity và action.
Thứ hai là validation engine. Engine đọc rule, tính metric và xác định PASS, WARN hoặc FAIL.
Thứ ba là reporting layer. Thành phần này lưu kết quả, tạo báo cáo hoặc chuyển cảnh báo cho người phụ trách.
Ví dụ về cấu trúc logic:
Rule:
name: primary_outcome_missingness
field: primary_outcome
metric: missing_rate
warning_threshold: 0.01
fail_threshold: 0.05
action_on_fail: block
Điểm đáng chú ý không nằm ở định dạng cấu hình mà ở việc rule được tách khỏi code xử lý dữ liệu. Khi threshold thay đổi, nhóm nghiên cứu có thể thay cấu hình và lưu phiên bản thay vì sửa logic pipeline ở nhiều nơi.
Một framework tốt cũng nên lưu phiên bản của dataset, code và rule cùng kết quả validation. Khi một kết quả nghiên cứu cần tái lập, nhóm không chỉ cần dữ liệu và script phân tích mà còn cần biết dữ liệu đã vượt qua bộ tiêu chí chất lượng nào tại thời điểm đó.
Tự động hóa kiểm tra dữ liệu nghiên cứu hiệu quả nhất khi chất lượng dữ liệu được biến thành một hệ thống quyết định có thể kiểm thử và truy vết: mỗi yêu cầu trở thành rule, mỗi điều kiện định lượng được gắn threshold, mỗi kết quả có trạng thái và mỗi trạng thái dẫn tới hành động xác định.
Trình tự thực tế nên bắt đầu từ những kiểm tra chắc chắn nhất như schema, kiểu dữ liệu, khóa, giá trị bắt buộc và quan hệ logic; sau đó mới mở rộng sang completeness, phân bố và bất thường thống kê. Các vi phạm chắc chắn có thể chặn pipeline, còn những tín hiệu chưa đủ căn cứ nên được cảnh báo để review.
Quan trọng hơn, validation không chỉ bảo vệ dữ liệu khỏi lỗi đầu vào. Khi được đặt ở nhiều checkpoint và kết hợp với invariant, logging cùng versioning, nó còn giúp phát hiện lỗi do chính quá trình cleaning, transformation và tích hợp dữ liệu tạo ra. Khi đó, kiểm tra dữ liệu trở thành một thành phần có thể tái lập của workflow nghiên cứu thay vì một bước thủ công thực hiện vào cuối dự án.
Hỏi đáp về tự động hóa kiểm tra dữ liệu nghiên cứu
Có nên tự động xóa mọi bản ghi không đạt rule không?
Không. Chỉ nên tự động loại bỏ hoặc cách ly dữ liệu khi rule phản ánh một điều kiện không thể chấp nhận và chính sách xử lý đã được xác định trước. Với outlier hoặc những bất thường chưa chắc là lỗi, cách phù hợp hơn thường là gắn cờ để review.
Nên dùng một threshold chung cho toàn bộ dataset không?
Thông thường không. Mức rủi ro của từng biến khác nhau. Một biến khóa, biến kết cục chính và biến mô tả phụ không nhất thiết phải có cùng yêu cầu về missingness hoặc sai lệch. Threshold nên gắn với vai trò của dữ liệu và mục tiêu phân tích.
Nên kiểm tra dữ liệu ở đầu hay cuối workflow?
Nên kiểm tra ở nhiều checkpoint. Kiểm tra đầu vào phát hiện lỗi nguồn; kiểm tra sau transformation phát hiện lỗi do xử lý; kiểm tra trước phân tích xác nhận dataset đáp ứng các điều kiện cần thiết cho bước phân tích.
Làm sao tránh hệ thống tạo quá nhiều cảnh báo?
Phân biệt rõ WARN và FAIL, theo dõi tỷ lệ cảnh báo thực sự dẫn đến vấn đề và định kỳ hiệu chỉnh threshold. Một cảnh báo không tạo ra hành động hữu ích trong thời gian dài là tín hiệu cho thấy rule hoặc ngưỡng cần được xem xét lại.
Có cần lưu phiên bản của rule kiểm tra không?
Có. Nếu rule hoặc threshold thay đổi theo thời gian, cùng một dataset có thể nhận kết quả validation khác nhau. Lưu phiên bản rule giúp giải thích vì sao dữ liệu từng được chấp nhận hoặc từ chối và hỗ trợ khả năng tái lập của workflow nghiên cứu.

GỬI Ý KIẾN BÌNH LUẬN

