
Quy tắc đặt tên tệp dữ liệu nghiên cứu nhất quán
Mục lục
- Vì sao cần xây dựng quy tắc đặt tên tệp dữ liệu nghiên cứu?
- Các thành phần cần có trong tên tệp dữ liệu nghiên cứu
- Nguyên tắc viết tên tệp dữ liệu nghiên cứu nhất quán
- Những lỗi phổ biến khi đặt tên tệp dữ liệu nghiên cứu
- Cách xây dựng quy trình quản lý tên tệp trong nhóm nghiên cứu
- Quy tắc đặt tên tệp dữ liệu nghiên cứu nên ưu tiên điều gì?
Quy tắc đặt tên tệp dữ liệu nghiên cứu nhất quán giúp nhóm nghiên cứu kiểm soát phiên bản, tìm kiếm nhanh, giảm nhầm lẫn và duy trì khả năng tái sử dụng dữ liệu trong suốt vòng đời nghiên cứu
Việc đặt tên tệp dữ liệu nghiên cứu không chỉ là vấn đề tổ chức thư mục mà còn là một phần của quản lý dữ liệu khoa học. Một hệ thống tên tệp nhất quán giúp người nghiên cứu hiểu nội dung tệp mà không cần mở trực tiếp, xác định đúng phiên bản dữ liệu, theo dõi lịch sử thay đổi và hỗ trợ chia sẻ dữ liệu giữa các thành viên trong nhóm.
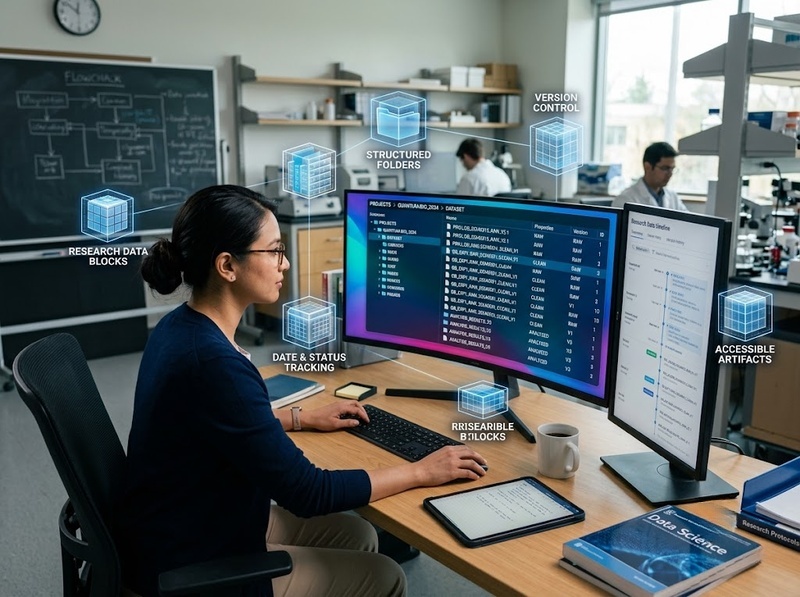
Một quy tắc đặt tên hiệu quả cần cân bằng giữa khả năng mô tả thông tin và tính đơn giản khi sử dụng. Tên tệp nên chứa những thông tin có giá trị quản lý lâu dài thay vì chỉ mô tả chung chung hoặc phụ thuộc vào trí nhớ cá nhân.
Vì sao cần xây dựng quy tắc đặt tên tệp dữ liệu nghiên cứu?
Dữ liệu nghiên cứu thường trải qua nhiều giai đoạn như thu thập, làm sạch, phân tích, cập nhật và xuất bản. Trong quá trình này, số lượng tệp có thể tăng nhanh và tạo ra nhiều phiên bản khác nhau.
Một hệ thống đặt tên không nhất quán dễ dẫn đến:
· Nhầm lẫn giữa dữ liệu gốc và dữ liệu đã xử lý
· Khó xác định phiên bản mới nhất
· Mất thời gian tìm kiếm tệp cần sử dụng
· Khó truy xuất nguồn gốc của dữ liệu
· Tăng nguy cơ sử dụng sai dữ liệu trong phân tích
Ngược lại, quy tắc đặt tên rõ ràng tạo ra một ngôn ngữ chung cho toàn bộ nhóm nghiên cứu, giúp mọi thành viên hiểu cấu trúc dữ liệu ngay cả khi không phải người tạo ra tệp.
Các thành phần cần có trong tên tệp dữ liệu nghiên cứu
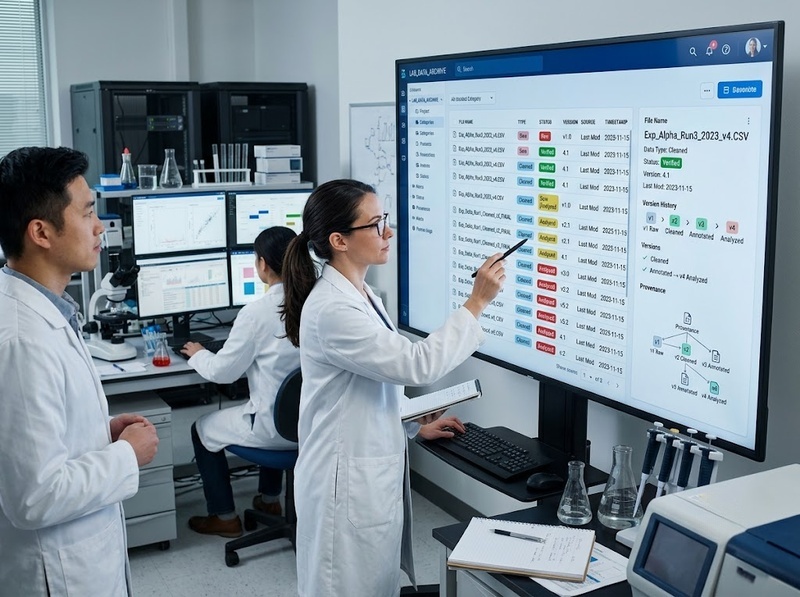
Một tên tệp nghiên cứu nên được xây dựng từ các thành phần có ý nghĩa quản lý. Không phải mọi tệp đều cần tất cả thành phần, nhưng cấu trúc nên được xác định trước và áp dụng thống nhất.
Các thành phần thường được sử dụng gồm:
· Tên dự án hoặc mã nghiên cứu
· Loại dữ liệu
· Đối tượng hoặc mẫu nghiên cứu
· Thời gian thu thập dữ liệu
· Trạng thái xử lý dữ liệu
· Phiên bản tệp
· Người tạo hoặc nguồn dữ liệu nếu cần
Ví dụ:
DuAnA_KhaoSat2026_DuLieuGoc_20260817_v01.csv
Tên tệp này cho phép nhận biết dự án, loại dữ liệu, trạng thái và phiên bản mà không cần mở tệp.
Nguyên tắc viết tên tệp dữ liệu nghiên cứu nhất quán
Sử dụng một cấu trúc tên tệp cố định
Trước khi tạo dữ liệu, nhóm nghiên cứu nên thống nhất một mẫu đặt tên chung.
Ví dụ:
[DuAn]_[LoaiDuLieu]_[ThoiGian]_[TrangThai]_[PhienBan]
Khi cấu trúc được duy trì, các tệp mới sẽ tự động nằm trong cùng một hệ thống logic.
Dùng định dạng thời gian có khả năng sắp xếp
Nên sử dụng định dạng ngày tháng theo chuẩn:
YYYYMMDD
Ví dụ:
20260817
Cách viết này giúp các tệp được sắp xếp theo thứ tự thời gian trong hệ thống quản lý tệp mà không cần chỉnh sửa thủ công.
Quản lý phiên bản bằng ký hiệu thống nhất
Không nên sử dụng các cách đặt tên như:
· File mới
· File cuối
· File cuối cùng
· File sửa lại
Các tên này dễ gây nhầm lẫn vì không phản ánh lịch sử thay đổi.
Nên sử dụng:
· v01
· v02
· v03
hoặc một hệ thống phiên bản được nhóm nghiên cứu quy định trước.
Phân biệt dữ liệu gốc và dữ liệu xử lý
Tên tệp cần thể hiện rõ trạng thái dữ liệu để tránh sử dụng nhầm.
Ví dụ:
· sample_raw_v01.csv cho dữ liệu ban đầu
· sample_cleaned_v01.csv cho dữ liệu đã làm sạch
· sample_analysis_v01.csv cho dữ liệu phục vụ phân tích
Sự phân biệt này giúp duy trì khả năng truy xuất toàn bộ quy trình xử lý dữ liệu.
Những lỗi phổ biến khi đặt tên tệp dữ liệu nghiên cứu
Một số cách đặt tên tưởng như thuận tiện trong ngắn hạn nhưng gây khó khăn khi dữ liệu mở rộng.
Đặt tên quá chung chung
Ví dụ:
data.xlsx
Tên này không cho biết dữ liệu thuộc nghiên cứu nào, thời điểm nào hoặc trạng thái xử lý ra sao.
Dùng ký tự không nhất quán
Việc trộn lẫn dấu cách, dấu gạch ngang, dấu gạch dưới hoặc ký tự đặc biệt có thể gây khó khăn khi tìm kiếm và xử lý tự động.
Nên chọn một quy tắc duy nhất, ví dụ sử dụng dấu gạch dưới:
DuAn_Mau_ThoiGian_PhiênBan
Phụ thuộc vào trí nhớ cá nhân
Một hệ thống tốt phải giúp người khác hiểu tệp mà không cần hỏi người tạo.
Tên tệp không nên dựa trên các ghi chú cá nhân như:
· File của tôi
· Dữ liệu mới
· Bản sửa của Minh
· Bản dùng để chạy hôm qua
Cách xây dựng quy trình quản lý tên tệp trong nhóm nghiên cứu
Để duy trì tính nhất quán lâu dài, nhóm nghiên cứu nên thiết lập quy trình ngay từ đầu dự án.
Các bước thực hiện:
· Xác định cấu trúc tên tệp chuẩn trước khi thu thập dữ liệu
· Tạo tài liệu hướng dẫn đặt tên chung cho nhóm
· Quy định cách viết ngày tháng và phiên bản
· Thống nhất danh mục trạng thái dữ liệu
· Kiểm tra tên tệp trước khi chia sẻ hoặc lưu trữ dài hạn
Ngoài tên tệp, quy trình quản lý dữ liệu nên kết hợp với cấu trúc thư mục, hệ thống kiểm soát phiên bản và tài liệu mô tả dữ liệu để đảm bảo khả năng truy xuất đầy đủ.
Quy tắc đặt tên tệp dữ liệu nghiên cứu nên ưu tiên điều gì?
Một hệ thống đặt tên tốt không cần quá phức tạp. Mục tiêu chính là giúp người dùng trả lời nhanh các câu hỏi:
· Đây là dữ liệu của nghiên cứu nào?
· Dữ liệu được tạo khi nào?
· Đây là bản gốc hay bản đã xử lý?
· Phiên bản hiện tại là phiên bản nào?
· Ai có thể hiểu và sử dụng tệp này?
Do đó, ưu tiên quan trọng nhất là tính nhất quán, khả năng đọc hiểu và khả năng mở rộng khi số lượng dữ liệu tăng lên.
Một quy tắc đặt tên tệp dữ liệu nghiên cứu hiệu quả cần được xem như một tiêu chuẩn quản lý dữ liệu trong toàn bộ vòng đời nghiên cứu. Khi tên tệp được xây dựng có hệ thống, nhóm nghiên cứu có thể giảm sai sót, tăng tốc độ truy xuất và duy trì tính minh bạch của dữ liệu.
Hỏi đáp về quy tắc đặt tên tệp dữ liệu nghiên cứu
Có nên đưa tất cả thông tin vào tên tệp dữ liệu nghiên cứu không?
Không nên. Tên tệp chỉ nên chứa những thông tin cần thiết để nhận diện và quản lý. Các thông tin chi tiết hơn nên được lưu trong tài liệu mô tả dữ liệu hoặc metadata.
Có nên đổi tên tệp sau khi đã chia sẻ cho nhóm nghiên cứu không?
Nên hạn chế đổi tên sau khi tệp đã được sử dụng trong quy trình nghiên cứu. Nếu cần thay đổi, nên tạo phiên bản mới để duy trì khả năng truy xuất lịch sử.
Quy tắc đặt tên tệp có áp dụng cho mọi loại dữ liệu nghiên cứu không?
Có thể áp dụng cho nhiều loại dữ liệu như dữ liệu khảo sát, dữ liệu thí nghiệm, dữ liệu mô phỏng hoặc dữ liệu phân tích. Tuy nhiên, từng lĩnh vực có thể điều chỉnh thêm các thành phần phù hợp với đặc thù nghiên cứu.

GỬI Ý KIẾN BÌNH LUẬN

