
Cách lưu trữ dữ liệu nghiên cứu có hệ thống
Mục lục
- Thiết lập cấu trúc thư mục và quy ước tên tệp ngay từ đầu
- Ghi metadata và provenance để dữ liệu không mất ngữ cảnh
- Kiểm soát phiên bản để tránh ghi đè và nhầm lẫn giữa các bản dữ liệu
- Xây dựng sao lưu có khả năng khôi phục thay vì chỉ đồng bộ dữ liệu
- Kiểm soát quyền truy cập và tính toàn vẹn của dữ liệu
- Chuẩn bị dữ liệu cho lưu giữ và truy xuất dài hạn
Hướng dẫn xây dựng hệ thống lưu trữ dữ liệu nghiên cứu có cấu trúc, metadata, quản lý phiên bản, sao lưu, kiểm soát truy cập và phương án lưu giữ dài hạn để dữ liệu an toàn, dễ tìm và có thể khôi phục.
Lưu trữ có hệ thống không đơn giản là gom toàn bộ tệp vào một ổ đĩa hoặc một dịch vụ đồng bộ. Một hệ thống tốt phải giải quyết đồng thời hai việc: tổ chức để tìm và hiểu đúng dữ liệu, đồng thời bảo vệ để có thể khôi phục dữ liệu khi xảy ra xóa nhầm, ghi đè, hỏng tệp hoặc mất thiết bị. Vì vậy, tổ chức dữ liệu và sao lưu là hai lớp khác nhau; làm tốt lớp thứ nhất không thay thế lớp thứ hai.
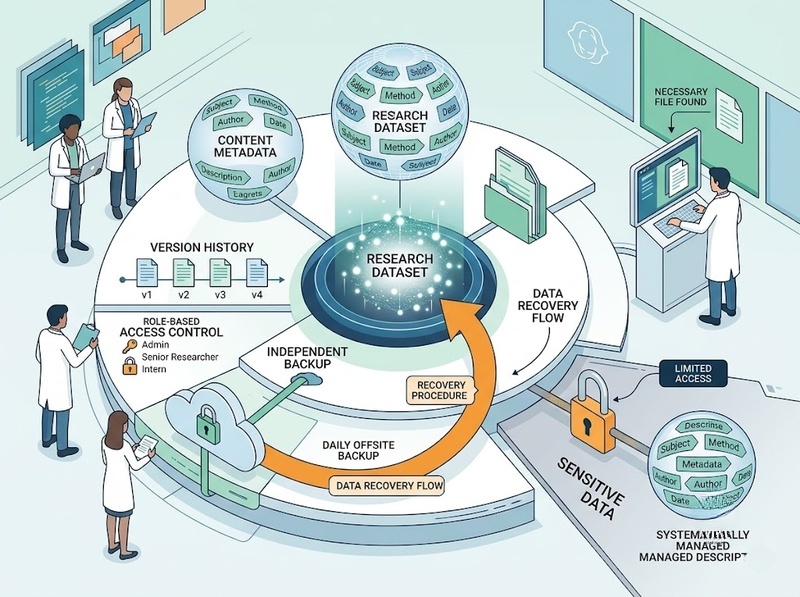
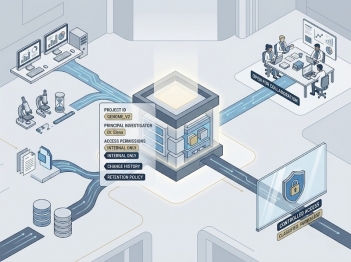
Ở mức thực hành, mỗi tệp quan trọng nên trả lời được các câu hỏi: đây là dữ liệu gì, thuộc dự án nào, phiên bản nào, được tạo hoặc thay đổi khi nào, ai chịu trách nhiệm, có metadata ở đâu, được sao lưu ở đâu và ai được phép xem hoặc sửa. Khi các quy tắc này được định nghĩa từ đầu và áp dụng nhất quán, việc truy xuất không còn phụ thuộc vào trí nhớ của một cá nhân.
Nguyên tắc FAIR và Data Management Plan (DMP) hữu ích ở vai trò khung định hướng: dữ liệu cần có khả năng được tìm thấy, truy cập theo điều kiện rõ ràng và được mô tả đủ để hiểu hoặc tái sử dụng. FAIR không đồng nghĩa với việc mọi dữ liệu phải công khai; dữ liệu nhạy cảm vẫn có thể cần kiểm soát truy cập nghiêm ngặt.
Thiết lập cấu trúc thư mục và quy ước tên tệp ngay từ đầu
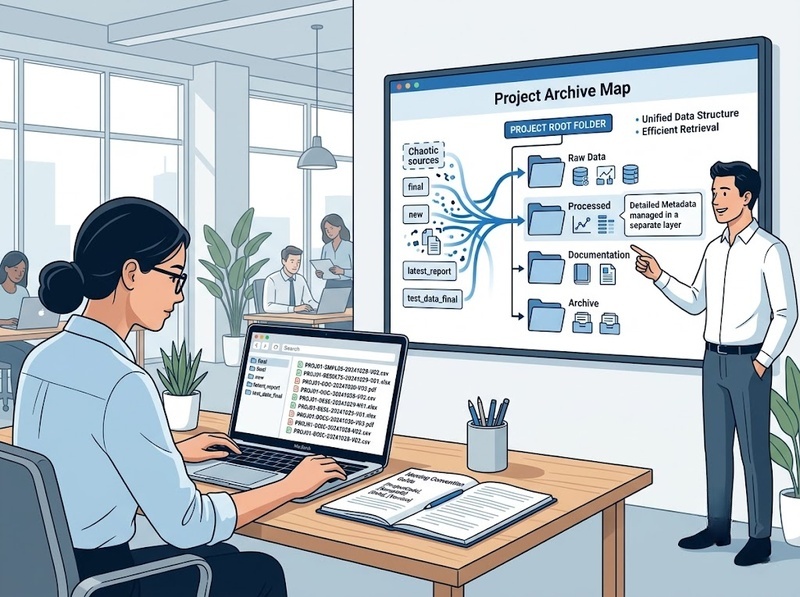
Một hệ thống lưu trữ dữ liệu nghiên cứu nên bắt đầu bằng cấu trúc cố định, không phải bằng việc chọn nơi có nhiều dung lượng. Cơ chế ở đây khá đơn giản: nếu cùng một loại dữ liệu luôn nằm ở cùng một vị trí logic và tên tệp luôn mang các trường thông tin theo cùng thứ tự, người dùng có thể suy ra vị trí hoặc nhận diện tệp mà không cần nhớ từng trường hợp riêng lẻ. Ngược lại, khi mỗi thành viên tự tạo thư mục và đặt tên theo thói quen, cấu trúc sẽ phản ánh trí nhớ cá nhân thay vì quy trình nghiên cứu.
Cấu trúc thư mục phải nhất quán hơn là cầu kỳ
Cây thư mục nên phản ánh các trạng thái cần quản lý của dự án và được giữ đủ nông để người dùng không phải lần qua quá nhiều lớp. Chẳng hạn, một dự án có thể tách rõ khu vực cho dữ liệu gốc, dữ liệu đang làm việc, tài liệu mô tả và bản lưu trữ. Giá trị của cách chia này không nằm ở tên thư mục cụ thể mà ở việc mỗi loại tệp có một “địa chỉ” dự đoán được.
Điểm cần tránh là tạo cấu trúc quá chi tiết ngay từ đầu rồi liên tục thay đổi. Mỗi lần đổi logic phân loại, liên kết trong tài liệu, đường dẫn trong quy trình và thói quen của nhóm đều có thể bị phá vỡ. DMP hoặc một tài liệu quản lý dự án ngắn nên ghi lại cấu trúc đã thống nhất để thành viên mới có thể áp dụng cùng một quy tắc.
Tên tệp cần mang thông tin đủ để nhận diện
Tên tệp nên sử dụng một mẫu cố định gồm những trường thực sự có giá trị nhận diện, chẳng hạn mã dự án, mã mẫu hoặc nhóm dữ liệu, ngày theo định dạng YYYY-MM-DD và số phiên bản. Một tên như PROJ01_SAMPLE12_2026-08-17_v03 cho phép sắp xếp và đọc nhanh hơn nhiều so với dulieu_moi_final_2.
Quy ước tên cần tránh ký hiệu mơ hồ như final, new, latest vì ý nghĩa của chúng thay đổi theo thời gian. Nếu số phiên bản đã được quản lý riêng, tên tệp không cần cố nhồi mọi metadata vào chuỗi tên. Đây là ranh giới quan trọng: tên tệp giúp nhận diện, còn metadata giúp hiểu đầy đủ ngữ cảnh. Cả hai cùng cần thiết, nhưng không thay thế nhau.
Ghi metadata và provenance để dữ liệu không mất ngữ cảnh
Một tệp có thể còn nguyên vẹn nhưng vẫn trở nên gần như vô dụng nếu không ai biết nó chứa gì, được tạo bằng quy trình nào hoặc các trường dữ liệu có ý nghĩa gì. Metadata giải quyết phần “dữ liệu nói về điều gì”, còn provenance giúp trả lời “dữ liệu này đến từ đâu và đã trải qua những thay đổi nào”. Đây là cơ chế biến một tập hợp tệp thành một tài sản nghiên cứu có thể được hiểu lại sau nhiều tháng hoặc bởi người không trực tiếp tạo ra nó.
Metadata tối thiểu phải trả lời được dữ liệu là gì
Ở cấp dự án, một tệp README hoặc tài liệu tương đương nên mô tả mục đích bộ dữ liệu, cấu trúc thư mục, quy ước tên, người chịu trách nhiệm, điều kiện truy cập và cách diễn giải các tệp chính. Ở cấp dữ liệu, metadata có thể ghi mô tả biến, đơn vị, mã hóa giá trị, thời điểm tạo, định dạng, phiên bản và các hạn chế sử dụng liên quan.
Nguyên tắc FAIR nhấn mạnh vai trò của metadata đối với khả năng tìm thấy và tái sử dụng. Ý nghĩa thực tế là dữ liệu không nên chỉ “có ở đâu đó”; nó cần được mô tả đủ để một người có quyền truy cập có thể xác định đúng bộ dữ liệu và hiểu cách sử dụng. Tuy nhiên, metadata cũng phải tuân theo boundary bảo mật: không đưa thông tin nhạy cảm vào trường mô tả công khai chỉ để làm metadata “đầy đủ hơn”.
Provenance giúp truy ngược dữ liệu đã được tạo và biến đổi ra sao
Provenance nên ghi lại nguồn gốc và các bước thay đổi quan trọng của dữ liệu. Khi có nhiều bản hoặc nhiều người cùng tham gia, thông tin này cho phép truy ngược từ một tệp hiện tại về nguồn và lý do thay đổi, thay vì phải suy đoán qua ngày sửa file.
Thực hành đơn giản là liên kết metadata với nhật ký thay đổi hoặc tài liệu mô tả quy trình. Nếu một tập dữ liệu được cập nhật, provenance phải đủ để biết bản nào là tiền nhiệm, thay đổi gì đã xảy ra và ai chịu trách nhiệm. Nhờ đó, khả năng truy xuất không chỉ là “tìm thấy tệp”, mà còn là tìm đúng tệp có đúng ngữ cảnh.
Kiểm soát phiên bản để tránh ghi đè và nhầm lẫn giữa các bản dữ liệu
Quản lý phiên bản tạo một trật tự thời gian cho dữ liệu. Mỗi thay đổi quan trọng được gắn với một phiên bản xác định, giúp nhóm nghiên cứu biết bản nào đang làm việc, bản nào đã được kiểm tra và bản nào cần được giữ để đối chiếu. Cơ chế này giảm hai rủi ro phổ biến: ghi đè lên trạng thái trước đó và sử dụng nhầm một bản cũ nhưng có tên “trông có vẻ mới”.
Một quy tắc như v01, v02, v03 có giá trị hơn các hậu tố final, final2, final_revised vì số phiên bản tạo được thứ tự rõ ràng. Với thay đổi quan trọng, nên có changelog hoặc audit trail ngắn nêu thời điểm, người thực hiện và nội dung thay đổi. Khi cần đối chiếu nguồn, bản gốc hoặc bản mốc quan trọng nên được giữ bất biến thay vì tiếp tục sửa trực tiếp.
Không phải mọi loại tệp đều cần một hệ thống kiểm soát phiên bản phức tạp. Nếu quy trình nhỏ và số người tham gia ít, quy ước phiên bản cộng với lịch sử thay đổi có thể đủ; khi cộng tác nhiều người hoặc tần suất thay đổi cao, cần cơ chế lưu lịch sử tự động đáng tin cậy hơn. Tiêu chí không phải là công cụ “mạnh” đến đâu mà là liệu nhóm có thể xác định chính xác bản nào, ai sửa, sửa khi nào và có thể quay lại trạng thái trước hay không.
Xây dựng sao lưu có khả năng khôi phục thay vì chỉ đồng bộ dữ liệu
Sao lưu chỉ có giá trị khi nó tạo ra một đường khôi phục độc lập với bản đang sử dụng. Đây là lý do đồng bộ và sao lưu không nên được xem là một việc. Đồng bộ giúp nhiều vị trí có cùng trạng thái; nhưng nếu một tệp bị xóa hoặc ghi đè và thay đổi đó được đồng bộ sang nơi khác, “bản sao” cũng có thể mất theo. Backup cần giữ được trạng thái có thể phục hồi ngay cả khi bản làm việc gặp lỗi.
Quy tắc 3-2-1 giảm phụ thuộc vào một bản sao
Một benchmark thực hành phổ biến là quy tắc 3-2-1: duy trì 3 bản dữ liệu tổng cộng, trên 2 loại phương tiện hoặc vị trí lưu trữ khác nhau, trong đó 1 bản ở ngoài vị trí chính. Ý nghĩa của các con số này là giảm điểm lỗi đơn: hỏng thiết bị, mất một nơi lưu hoặc lỗi ở bản làm việc không đồng thời xóa sạch mọi đường phục hồi.
3-2-1 là baseline, không phải công thức bất biến cho mọi dự án. Dữ liệu nhạy cảm có thể yêu cầu quyền truy cập và mã hóa chặt hơn ở bản sao ngoài vị trí; dự án nhỏ có thể triển khai bằng các loại lưu trữ đơn giản hơn. Điều không thay đổi là một bản duy nhất, dù nằm trên thiết bị tốt đến đâu, vẫn không tạo ra khả năng dự phòng.
Kiểm thử khôi phục mới xác nhận bản sao lưu có giá trị
Có file backup chưa đủ để chứng minh có thể phục hồi. Tệp có thể hỏng, bản sao có thể thiếu, quyền truy cập có thể bị mất hoặc quy trình restore có thể không còn hoạt động. Vì vậy, sao lưu cần gắn với kiểm thử khôi phục tại các mốc phù hợp với mức độ quan trọng của dữ liệu.
Không có một tần suất kiểm thử duy nhất phù hợp cho mọi nghiên cứu. Cách đặt ngưỡng hợp lý là dựa trên mức dữ liệu có thể chấp nhận mất và tốc độ thay đổi của dự án: dữ liệu thay đổi nhanh hoặc khó tái tạo cần kiểm tra nghiêm ngặt hơn dữ liệu ít thay đổi. Sau mỗi lần thử restore, nhóm cần biết bản nào đã được khôi phục, từ đâu và có đủ để tiếp tục công việc hay không.
Kiểm soát quyền truy cập và tính toàn vẹn của dữ liệu
An toàn không chỉ là “không mất tệp”. Dữ liệu cũng phải được bảo vệ khỏi việc xem, sửa hoặc xóa không phù hợp, đồng thời cần có cách phát hiện khi nội dung bị thay đổi ngoài dự kiến. Hai cơ chế bổ sung cho nhau ở đây là kiểm soát truy cập và kiểm tra tính toàn vẹn.
Phân quyền theo nhu cầu xem, sửa và xóa
Quyền nên được cấp theo vai trò thực tế: người chỉ cần đọc không nhất thiết có quyền sửa; người cần cập nhật không nhất thiết có quyền xóa; quyền quản trị chỉ dành cho số người cần thiết. Cách phân lớp này làm giảm phạm vi ảnh hưởng khi có thao tác nhầm hoặc tài khoản bị sử dụng sai mục đích.
Mức kiểm soát phải tương xứng với độ nhạy cảm của dữ liệu. Với dữ liệu cần bảo mật, mã hóa và kiểm soát truy cập phải được áp dụng cả ở nơi lưu chính lẫn bản sao phù hợp. Ngược lại, thêm quá nhiều lớp kiểm soát vào dữ liệu ít nhạy cảm có thể làm quy trình khó vận hành. Mục tiêu là quyền truy cập rõ ràng, có chủ đích và có thể kiểm tra lại.
Checksum giúp phát hiện tệp bị thay đổi hoặc hỏng
Checksum/fixity tạo một giá trị đại diện cho nội dung tệp. Khi tính lại checksum ở thời điểm khác hoặc trên một bản sao, sự khác biệt cho biết nội dung không còn giống trạng thái tham chiếu. Đây là bằng chứng kỹ thuật trực tiếp để kiểm tra tính toàn vẹn, đặc biệt hữu ích khi chuyển dữ liệu giữa vị trí lưu trữ hoặc kiểm tra bản lưu dài hạn.
Checksum có boundary rõ ràng: nó phát hiện thay đổi, không tự ngăn xóa dữ liệu và không tạo bản phục hồi. Vì vậy, checksum không thay thế backup; nó giúp xác nhận rằng bản dữ liệu hoặc bản sao mà bạn đang dựa vào có còn đúng như trạng thái đã ghi nhận hay không. Các kho lưu trữ dữ liệu đáng tin cậy thường tích hợp thực hành fixity vào quy trình bảo quản chính vì lý do này.
Chuẩn bị dữ liệu cho lưu giữ và truy xuất dài hạn
Khi dự án kết thúc, mục tiêu chuyển từ “làm việc thuận tiện” sang “mở được, hiểu được và tìm lại được về sau”. Nếu dữ liệu chỉ tồn tại trong định dạng phụ thuộc vào một phần mềm hoặc trong thư mục cá nhân không còn được duy trì, khả năng truy xuất có thể suy giảm dù tệp chưa bị mất.
Ưu tiên định dạng có khả năng sử dụng lâu dài
Đối với dữ liệu cần giữ lâu, nên ưu tiên định dạng mở, không độc quyền hoặc ít nhất được tài liệu hóa rộng rãi, đồng thời giữ metadata mô tả cách diễn giải nội dung. Cơ chế ở đây là giảm phụ thuộc vào một phần mềm hoặc môi trường cụ thể. Khi bắt buộc phải giữ định dạng chuyên dụng, tài liệu hóa phiên bản và điều kiện mở tệp trở nên quan trọng hơn.
Không phải mọi tệp trung gian đều cần được giữ vô thời hạn. DMP nên xác định nhóm dữ liệu nào cần lưu, thời hạn retention, ai chịu trách nhiệm và điều kiện truy cập. Việc này giúp hệ thống không biến thành một kho tích lũy không phân biệt, nơi dữ liệu quan trọng bị chôn trong nhiều bản dư thừa.
Kho dữ liệu nghiên cứu hỗ trợ truy xuất sau khi dự án kết thúc
Kho dữ liệu nghiên cứu bổ sung những chức năng mà thư mục cá nhân thường thiếu: metadata có cấu trúc, quản lý truy cập, định danh bền vững và quy trình bảo quản. Khi phù hợp với yêu cầu của dự án, việc chuyển dữ liệu cần lưu giữ sang một repository đáng tin cậy giúp tách dữ liệu khỏi vòng đời của thiết bị hoặc tài khoản cá nhân.
Nguyên tắc FAIR hữu ích ở bước này vì nó đặt trọng tâm vào khả năng tìm thấy và tái sử dụng, nhưng FAIR không buộc dữ liệu phải mở cho tất cả mọi người. Dữ liệu có hạn chế vẫn có thể được mô tả bằng metadata và cung cấp cơ chế truy cập có điều kiện. Trước khi kết thúc dự án, cần hoàn thiện metadata, xác nhận phiên bản cần lưu, kiểm tra tính toàn vẹn và bảo đảm quyền truy cập của kho phù hợp với mức độ nhạy cảm của dữ liệu.
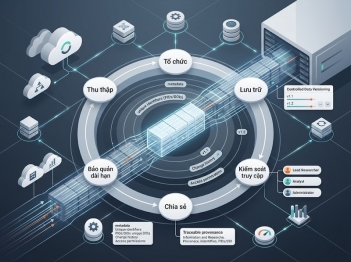
Một hệ thống lưu trữ dữ liệu nghiên cứu đáng tin cậy không dựa vào một thao tác duy nhất, mà vào chuỗi quy tắc được áp dụng nhất quán: cấu trúc thư mục và tên tệp giúp nhận diện; metadata và provenance giữ ngữ cảnh; quản lý phiên bản bảo toàn lịch sử thay đổi; backup tạo khả năng khôi phục; phân quyền và checksum bảo vệ quyền truy cập và tính toàn vẹn; định dạng phù hợp cùng repository hỗ trợ lưu giữ dài hạn.
Điểm quan trọng nhất là biến các quy tắc này thành quy trình của dự án ngay từ đầu. Khi mỗi thành viên biết dữ liệu phải đặt ở đâu, đặt tên thế nào, phiên bản nào đang dùng, bản sao ở đâu và ai có quyền thao tác, việc lưu trữ dữ liệu nghiên cứu trở nên vừa an toàn hơn vừa dễ truy xuất hơn mà không phụ thuộc vào trí nhớ cá nhân.

GỬI Ý KIẾN BÌNH LUẬN

