
Vai trò của hệ thống quản lý dữ liệu nghiên cứu
Mục lục
- Hệ thống quản lý dữ liệu nghiên cứu giữ vai trò trung tâm nào?
- Lưu trữ dữ liệu nghiên cứu có cấu trúc và khả năng phục hồi
- Kiểm soát truy cập, phiên bản và lịch sử thay đổi
- Bảo vệ tính toàn vẹn và khả năng truy xuất nguồn gốc dữ liệu
- Hỗ trợ tìm kiếm, chia sẻ và tái sử dụng dữ liệu nghiên cứu
- Giới hạn của hệ thống và điều kiện để kiểm soát thực sự hiệu quả
Hệ thống quản lý dữ liệu nghiên cứu không chỉ cung cấp nơi lưu tệp mà còn tổ chức metadata, kiểm soát quyền truy cập, quản lý phiên bản, duy trì khả năng truy xuất và hỗ trợ chia sẻ dữ liệu có kiểm soát. Bài viết làm rõ vai trò, cơ chế vận hành và giới hạn của hệ thống trong thực tế nghiên cứu.
Một hệ thống quản lý dữ liệu nghiên cứu cần được hiểu rộng hơn một ổ lưu trữ tập trung. Giá trị cốt lõi của hệ thống nằm ở việc biến dữ liệu rời rạc thành đối tượng có thể quản trị: dữ liệu được mô tả bằng metadata, gắn với người hoặc dự án chịu trách nhiệm, đặt dưới quyền truy cập xác định, có lịch sử thay đổi và có quy tắc về lưu giữ, phục hồi, chia sẻ. Cách tiếp cận này phù hợp với các nguyên tắc FAIR, trong đó dữ liệu và metadata cần có khả năng được tìm thấy, truy cập, liên thông và tái sử dụng.
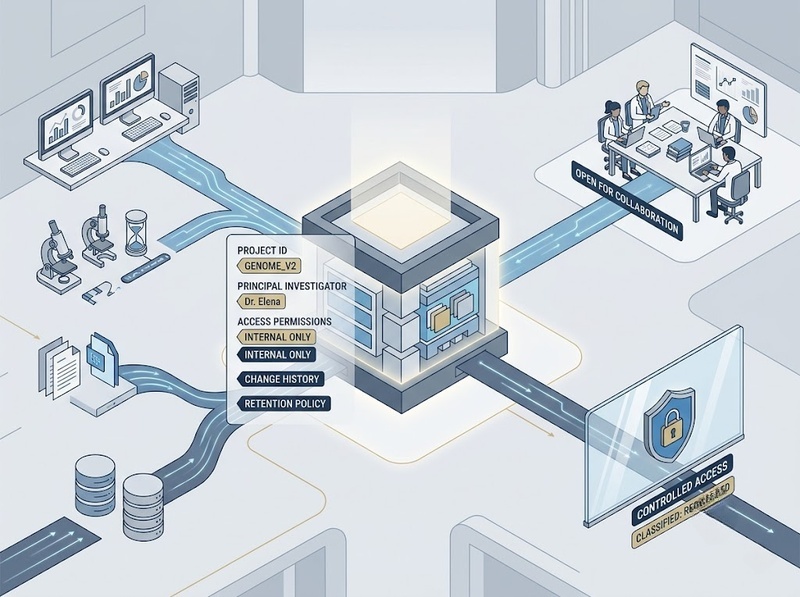
Vì vậy, “lưu trữ” chỉ là một phần của bài toán. Phần còn lại là kiểm soát dữ liệu trong suốt vòng đời nghiên cứu để người có thẩm quyền có thể biết dữ liệu nào đang tồn tại, phiên bản nào được sử dụng, ai được phép thao tác, thay đổi nào đã xảy ra và dữ liệu có thể được chia sẻ trong điều kiện nào. NIH cũng xem quản lý dữ liệu phù hợp là yếu tố quan trọng đối với tính nghiêm ngặt khoa học và tính toàn vẹn của nghiên cứu.
Hệ thống quản lý dữ liệu nghiên cứu giữ vai trò trung tâm nào?
Vai trò trung tâm của hệ thống là tạo một lớp quản trị nhất quán giữa dữ liệu và hoạt động nghiên cứu. Thay vì mỗi thành viên lưu dữ liệu theo cách riêng trên máy cá nhân, ổ dùng chung hoặc nhiều dịch vụ tách biệt, hệ thống đặt dữ liệu vào một môi trường có cấu trúc và quy tắc quản lý chung.
Cơ chế này giải quyết một vấn đề quan trọng: dữ liệu nghiên cứu chỉ có giá trị lâu dài khi người khác — hoặc chính nhóm nghiên cứu sau một khoảng thời gian — có thể xác định dữ liệu là gì, được tạo ra trong bối cảnh nào, phiên bản nào đáng tin cậy và được phép sử dụng ra sao. FAIR nhấn mạnh vai trò của metadata phong phú, định danh bền vững và khả năng lập chỉ mục để dữ liệu có thể được phát hiện và tái sử dụng.
Ở góc độ vận hành, hệ thống thường kết nối bốn chức năng: bảo quản dữ liệu, tổ chức ngữ cảnh, kiểm soát sử dụng và tạo điều kiện cho việc tìm kiếm hoặc chia sẻ. Đây cũng là lý do một hệ thống quản lý dữ liệu không thay thế phương pháp nghiên cứu hay kiểm soát chất lượng khoa học; nó tạo ra môi trường để các quy tắc đó được thực thi nhất quán hơn.
Đối với nghiên cứu chịu yêu cầu quản lý dữ liệu chính thức, vai trò này còn thể hiện ở khả năng liên kết dữ liệu với kế hoạch lưu giữ và chia sẻ. Chẳng hạn, định dạng Data Management and Sharing Plan mà NIH áp dụng trong năm 2026 yêu cầu xem xét loại dữ liệu, nơi lưu trữ/chia sẻ, thời gian cung cấp dữ liệu, thời gian duy trì dữ liệu và các giới hạn do yếu tố đạo đức, pháp lý hoặc kỹ thuật. Các yêu cầu này chỉ áp dụng trong phạm vi chính sách NIH, nhưng chúng minh họa rõ những thành phần mà quản trị dữ liệu nghiên cứu phải xử lý.
Lưu trữ dữ liệu nghiên cứu có cấu trúc và khả năng phục hồi
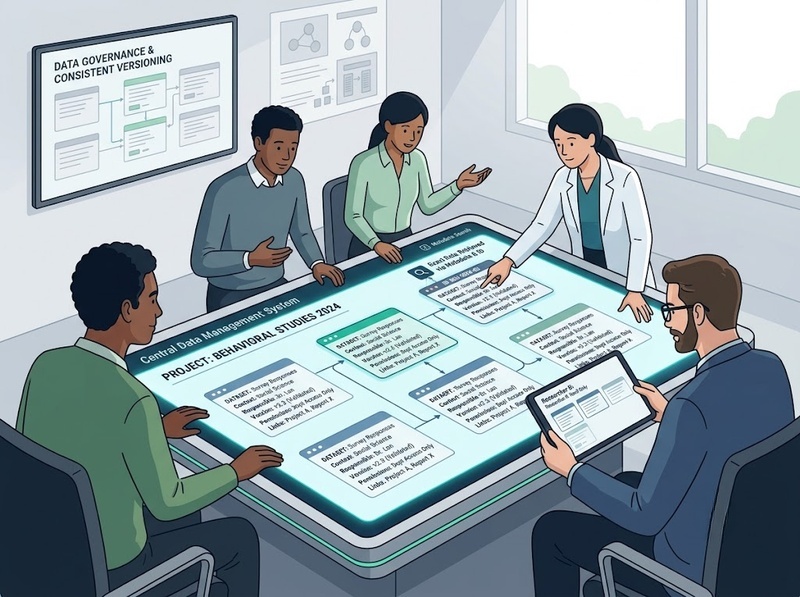
Một hệ thống quản lý dữ liệu tốt không chỉ trả lời câu hỏi “tệp nằm ở đâu?” mà còn phải trả lời “tệp này thuộc nghiên cứu nào, có ý nghĩa gì và cần được giữ trong bao lâu?”. Vì vậy, lưu trữ có quản lý bắt đầu từ việc gắn dữ liệu với cấu trúc thư mục, bộ sưu tập hoặc dataset cùng metadata mô tả.
Metadata có thể ghi nhận những yếu tố như dự án, người tạo, thời điểm thu thập, loại dữ liệu, phiên bản, định dạng và điều kiện truy cập. Khi thông tin này được chuẩn hóa và có thể tìm kiếm, dữ liệu không còn phụ thuộc hoàn toàn vào tên tệp hoặc trí nhớ của một cá nhân. FAIR cụ thể hóa nguyên tắc này bằng yêu cầu về định danh bền vững, metadata phong phú và việc đăng ký hoặc lập chỉ mục dữ liệu trong tài nguyên có khả năng tìm kiếm.
Về mặt lưu giữ, dữ liệu cũng có thể không nằm trên một máy chủ vật lý duy nhất. Một tổ chức có thể sử dụng kho dữ liệu chuyên ngành, hạ tầng nội bộ hoặc dịch vụ lưu trữ khác nhau; điều quan trọng là hệ thống quản lý phải duy trì được cấu trúc, metadata và quy tắc quản trị nhất quán. NIH hiện khuyến nghị sử dụng các repository đã được thiết lập để bảo quản và chia sẻ dữ liệu khoa học khi có repository phù hợp.
Khả năng phục hồi là lớp chức năng khác với lưu trữ thông thường. Hệ thống cần hỗ trợ hoặc tích hợp cơ chế sao lưu, phục hồi và lưu giữ để giảm nguy cơ dữ liệu biến mất khi thiết bị hỏng, người dùng xóa nhầm hoặc tài nguyên vận hành gặp sự cố. Trong NIST SP 800-53, Contingency Planning, Media Protection và System and Information Integrity đều được xác định là các nhóm kiểm soát riêng trong quản trị an toàn hệ thống thông tin.
Tuy nhiên, có bản sao dữ liệu không đồng nghĩa với quản lý dữ liệu tốt. Một bản sao không có metadata, không xác định phiên bản và không có quy tắc lưu giữ vẫn có thể trở thành dữ liệu khó hiểu hoặc không thể tái sử dụng.
Kiểm soát truy cập, phiên bản và lịch sử thay đổi
“Kiểm soát” trong hệ thống quản lý dữ liệu nghiên cứu trước hết là kiểm soát ai được làm gì với dữ liệu. Hệ thống cần phân biệt nhận dạng người dùng với quyền của người dùng: một người có thể đăng nhập hợp lệ nhưng chỉ được xem một dataset, trong khi thành viên khác được phép cập nhật hoặc phê duyệt thay đổi.
Cơ chế này thường dựa trên tài khoản, nhóm người dùng, vai trò dự án và mức quyền đối với từng tài nguyên. NIST SP 800-53 tách Access Control, Identification and Authentication, cùng Audit and Accountability thành các nhóm kiểm soát độc lập. Điều đó cho thấy kiểm soát truy cập không chỉ là đặt mật khẩu; nó còn liên quan đến việc xác thực danh tính, cấp quyền phù hợp và ghi nhận hoạt động để có thể kiểm tra về sau.
Lớp kiểm soát thứ hai là quản lý phiên bản. Khi dữ liệu được làm sạch, bổ sung hoặc sửa lỗi, hệ thống cần giúp phân biệt trạng thái trước và sau thay đổi thay vì để các tệp như final, final2 hay final_moi_nhat tồn tại song song mà không có quan hệ rõ ràng. Với các đối tượng nghiên cứu đã được công bố bằng DOI, DataCite khuyến nghị gán DOI mới cho phiên bản lớn và sử dụng quan hệ metadata để liên kết các phiên bản; với cập nhật nhỏ, DOI mới có thể không cần thiết.
Nguyên tắc đó không có nghĩa mọi tệp làm việc nội bộ đều cần DOI. Ý nghĩa thực tế nằm ở việc hệ thống phải có quy ước phiên bản phù hợp với mức độ quan trọng của dữ liệu: thay đổi nào cần tạo phiên bản mới, phiên bản nào được coi là chính thức và có thể quay lại trạng thái trước hay không.
Lớp thứ ba là lịch sử hoạt động. Audit trail hoặc nhật ký hệ thống giúp trả lời các câu hỏi như ai đã truy cập, ai thay đổi dữ liệu và thay đổi xảy ra khi nào. Cơ chế này đặc biệt quan trọng khi nhiều người cùng làm việc trên một dataset, bởi quyền truy cập mà không có khả năng truy vết vẫn để lại khoảng trống lớn trong kiểm soát. NIST coi Audit and Accountability là một nhóm kiểm soát riêng chính vì khả năng kiểm tra sau sự kiện là một phần của quản trị hệ thống, không phải chức năng phụ.
Bảo vệ tính toàn vẹn và khả năng truy xuất nguồn gốc dữ liệu
Một dataset nghiên cứu có thể vẫn tồn tại nhưng mất giá trị nếu không xác định được nó đã bị thay đổi thế nào. Vì vậy, hệ thống quản lý dữ liệu còn có vai trò bảo vệ tính toàn vẹn: dữ liệu đang được sử dụng phải có trạng thái xác định và các thay đổi quan trọng phải có khả năng được phát hiện hoặc truy vết.
Cơ chế này hình thành từ sự kết hợp giữa quyền sửa dữ liệu, quản lý phiên bản, nhật ký hoạt động, metadata và quy trình phục hồi. Nếu một người không có quyền không thể tự ý ghi đè dữ liệu, nếu phiên bản trước vẫn được bảo tồn và nếu hành động cập nhật được ghi lại, nguy cơ mất dấu lịch sử xử lý sẽ thấp hơn. NIST SP 800-53 dành riêng các nhóm System and Information Integrity, Audit and Accountability và Contingency Planning cho những mục tiêu kiểm soát tương ứng.
Khả năng truy xuất nguồn gốc đi xa hơn việc biết “ai sửa tệp”. Trong nghiên cứu, người dùng còn cần hiểu dữ liệu xuất phát từ đâu, được thu thập hoặc tạo trong điều kiện nào, đã trải qua bước xử lý nào và kết quả hiện tại liên hệ với dữ liệu gốc ra sao. Metadata và quan hệ giữa các đối tượng nghiên cứu chính là phương tiện để duy trì ngữ cảnh đó. DataCite, chẳng hạn, sử dụng metadata và các quan hệ định danh để biểu diễn mối liên hệ giữa những phiên bản hoặc tài nguyên nghiên cứu.
Một hiểu nhầm phổ biến là hệ thống quản lý dữ liệu có thể tự bảo đảm dữ liệu “đúng”. Trên thực tế, hệ thống có thể bảo vệ trạng thái, quyền, lịch sử và bằng chứng về quá trình xử lý; nó không thể xác nhận một phép đo được thực hiện đúng phương pháp nếu quy trình nghiên cứu ban đầu đã sai. Đây là ranh giới quan trọng giữa data integrity ở cấp quản trị hệ thống và scientific validity ở cấp phương pháp nghiên cứu.
Hỗ trợ tìm kiếm, chia sẻ và tái sử dụng dữ liệu nghiên cứu
Dữ liệu được lưu an toàn nhưng không thể tìm lại hoặc không đủ ngữ cảnh để người khác hiểu vẫn tạo ra giá trị hạn chế. Vì vậy, một vai trò khác của hệ thống là chuyển dữ liệu từ trạng thái “đã lưu” sang trạng thái “có thể được phát hiện và sử dụng đúng điều kiện”.
FAIR mô tả quá trình này qua bốn đặc tính Findable, Accessible, Interoperable và Reusable. Đáng chú ý, “Accessible” không có nghĩa dữ liệu bắt buộc phải công khai. Các nguyên tắc FAIR cho phép quy trình xác thực và cấp quyền khi cần thiết, nghĩa là một dataset vẫn có thể được quản lý theo FAIR trong khi quyền truy cập được kiểm soát.
Hệ thống hỗ trợ khả năng tìm kiếm bằng metadata, chỉ mục và định danh; hỗ trợ khả năng tái sử dụng bằng cách duy trì mô tả đủ rõ về dữ liệu; và hỗ trợ chia sẻ bằng cách gắn điều kiện truy cập với dataset. Với dữ liệu được xuất bản, DataCite yêu cầu DOI trỏ tới landing page có metadata và phương thức tiếp cận tài nguyên, qua đó tạo một liên kết bền vững giữa định danh, mô tả và dữ liệu.
Điều quan trọng là chia sẻ phải được đặt sau kiểm soát. Trong hướng dẫn DMS hiện hành, NIH thừa nhận các giới hạn đạo đức, pháp lý hoặc kỹ thuật có thể khiến dữ liệu không thể chia sẻ hoàn toàn; với dữ liệu từ người tham gia nghiên cứu, quyền riêng tư và tính bảo mật còn có thể yêu cầu áp dụng cơ chế kiểm soát truy cập.
Do đó, vai trò của hệ thống không phải “đưa tất cả dữ liệu lên mạng”, mà là cho phép tổ chức xác định dữ liệu nào có thể được chia sẻ, cho ai, theo điều kiện nào và trong trạng thái nào. Đây là điểm mà lưu trữ, metadata và kiểm soát truy cập hội tụ thành quản trị dữ liệu thực sự.
Giới hạn của hệ thống và điều kiện để kiểm soát thực sự hiệu quả
Phần mềm không tự tạo ra quản trị. Một hệ thống có đầy đủ chức năng nhưng không có quy tắc về người chịu trách nhiệm, metadata, phiên bản hoặc quyền truy cập vẫn có thể trở thành một kho tệp lớn và khó kiểm soát. NIST cũng xác định các kiểm soát an toàn và quyền riêng tư là những cơ chế linh hoạt, cần được lựa chọn và triển khai trong một quá trình quản trị rủi ro của tổ chức, thay vì coi việc có một sản phẩm công nghệ là đủ để bảo đảm an toàn.
Để hệ thống thực sự hỗ trợ lưu trữ và kiểm soát dữ liệu nghiên cứu, tổ chức cần tối thiểu xác lập các nguyên tắc vận hành sau:
· Xác định người hoặc đơn vị chịu trách nhiệm đối với từng nhóm dữ liệu
· Quy định metadata tối thiểu và cách đặt tên, phân loại dữ liệu
· Phân quyền truy cập theo vai trò và nhu cầu nghiên cứu
· Quy định cách tạo phiên bản, ghi nhận và phê duyệt thay đổi quan trọng
· Thiết lập cơ chế sao lưu, phục hồi và thời hạn lưu giữ phù hợp
· Xác định điều kiện chia sẻ đối với dữ liệu nhạy cảm, hạn chế hoặc có yêu cầu về quyền riêng tư
Các lớp kiểm soát này luôn tạo ra trade-off. Phân quyền càng chặt có thể làm tăng số bước thao tác; mở quyền quá rộng lại làm tăng khả năng sử dụng dữ liệu ngoài mục đích. Lưu giữ nhiều phiên bản cải thiện khả năng truy vết nhưng làm tăng nhu cầu lưu trữ. Vì vậy, mục tiêu không phải áp dụng mức kiểm soát cao nhất cho mọi dataset mà là áp dụng mức kiểm soát phù hợp với rủi ro, giá trị và yêu cầu sử dụng của từng loại dữ liệu.
Các nguồn thẩm quyền cũng cần được hiểu đúng phạm vi. FAIR là bộ nguyên tắc về khả năng tìm thấy, truy cập, liên thông và tái sử dụng, không phải chứng nhận an ninh. NIST SP 800-53 cung cấp danh mục kiểm soát an toàn và quyền riêng tư có thể tùy chỉnh theo bối cảnh. Chính sách NIH áp dụng cho phạm vi nghiên cứu thuộc NIH, trong khi hướng dẫn DataCite chủ yếu liên quan đến định danh và metadata cho các đối tượng nghiên cứu được quản lý hoặc công bố. Sử dụng những khung này đúng vai trò sẽ hữu ích hơn việc xem một tiêu chuẩn đơn lẻ như câu trả lời cho toàn bộ bài toán quản lý dữ liệu.
Hệ thống quản lý dữ liệu nghiên cứu có vai trò biến việc “lưu dữ liệu” thành một quá trình có thể quản trị. Hệ thống tổ chức dữ liệu bằng cấu trúc và metadata, giới hạn quyền thao tác, duy trì phiên bản và lịch sử hoạt động, hỗ trợ bảo vệ tính toàn vẹn, đồng thời tạo điều kiện để dữ liệu được tìm kiếm, chia sẻ và tái sử dụng theo những điều kiện xác định. Các vai trò này phù hợp với cách các khung FAIR, NIH và NIST tiếp cận quản trị, chia sẻ và kiểm soát dữ liệu hoặc hệ thống thông tin.
Hiệu quả cuối cùng không đến từ phần mềm riêng lẻ mà từ sự kết hợp giữa hệ thống, quy tắc quản trị và hành vi của người sử dụng. Khi ba thành phần này đồng bộ, dữ liệu nghiên cứu không chỉ được giữ lại mà còn duy trì được ngữ cảnh, khả năng kiểm soát và giá trị sử dụng trong suốt vòng đời nghiên cứu.



GỬI Ý KIẾN BÌNH LUẬN

