
Cách thiết kế metadata dữ liệu nghiên cứu
Mục lục
- Thiết kế metadata bắt đầu từ mục đích sử dụng và đối tượng được mô tả
- Nhóm trường nhận diện và trích dẫn dữ liệu
- Nhóm trường giúp tìm kiếm và hiểu đúng dữ liệu
- Nhóm trường hỗ trợ nguồn gốc, liên kết và tái sử dụng
- Mỗi trường metadata cần được đặc tả bằng những quy tắc nào?
- Chọn chuẩn nền và kiểm thử bộ metadata trước khi áp dụng
Bài viết hướng dẫn cách xác định các trường metadata cho dữ liệu nghiên cứu, từ nhóm trường nhận diện, mô tả và truy tìm đến nguồn gốc, quyền tái sử dụng, quan hệ dữ liệu và các quy tắc bắt buộc phải đặc tả cho từng trường.
Một bộ metadata tốt không đơn thuần là danh sách các cột như “tên dữ liệu”, “tác giả”, “ngày tạo” hay “từ khóa”. Về bản chất, nó là một application profile: quy định dữ liệu nghiên cứu đang được mô tả ở cấp nào, trường nào được phép sử dụng, trường nào bắt buộc, có được lặp hay không, nhận loại giá trị gì và giá trị phải tuân theo quy tắc nào. DCMI cũng mô tả application profile theo hướng này: profile xác định các thuộc tính metadata và có thể đặt các ràng buộc về cardinality, kiểu giá trị và giá trị hợp lệ.
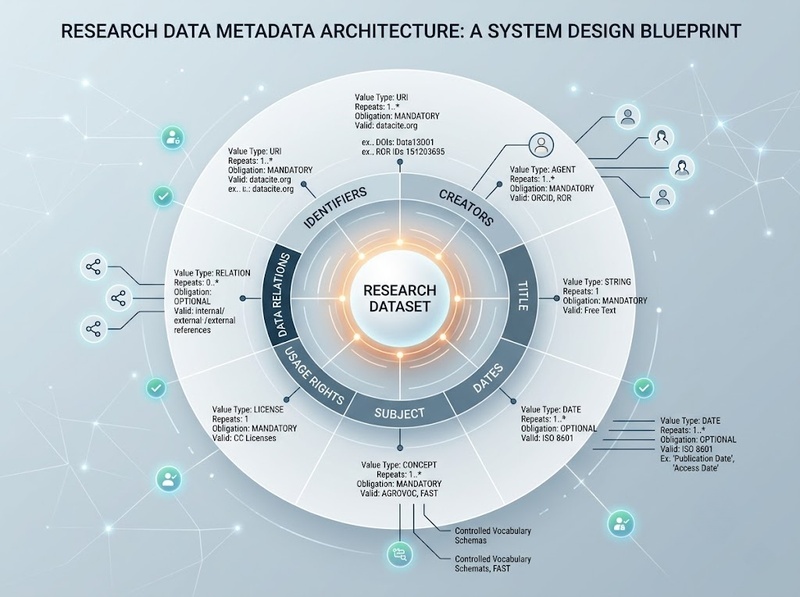
Vì thế, câu hỏi “cần những trường nào?” nên được giải quyết theo hai tầng. Tầng thứ nhất xác định những thông tin cần ghi lại để dữ liệu có thể được nhận diện, tìm thấy, hiểu, liên kết và tái sử dụng. Tầng thứ hai quy định cách biểu diễn từng thông tin đó để con người và phần mềm cùng xử lý nhất quán. Đây cũng là lý do không nên sao chép nguyên một danh sách trường từ tiêu chuẩn rồi coi đó là thiết kế metadata hoàn chỉnh.
Thiết kế metadata bắt đầu từ mục đích sử dụng và đối tượng được mô tả
Trước khi tạo trường, cần xác định metadata sẽ phục vụ chức năng nào. Một kho dữ liệu dùng chủ yếu để cấp DOI và trích dẫn cần mức mô tả khác với một hệ thống phải hỗ trợ nhà nghiên cứu tìm biến, hiểu phương pháp thu thập hoặc tái phân tích dữ liệu. DCMI coi mục tiêu, phạm vi, yêu cầu chức năng và mô hình các thực thể được mô tả là những thành phần nền tảng của một application profile.
Một cách thực tế là bắt đầu bằng các câu hỏi chức năng:
· Người dùng có cần nhận diện chính xác một bộ dữ liệu hay một phiên bản cụ thể không
· Họ có cần tìm kiếm theo chủ đề, thời gian, địa điểm hoặc người tạo không
· Họ có đủ thông tin để hiểu dữ liệu được tạo ra như thế nào không
· Họ có thể xác định quyền truy cập và điều kiện tái sử dụng không
· Họ có cần biết dữ liệu liên quan đến bài báo, dự án, phần mềm hoặc bộ dữ liệu nào khác không
· Hệ thống có cần trao đổi metadata với repository, DOI service hoặc catalog bên ngoài không
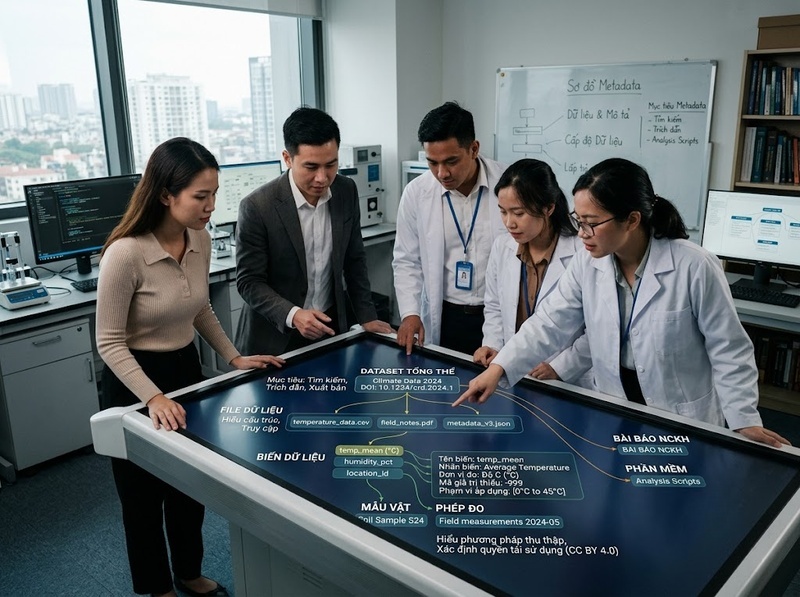
Bước tiếp theo là xác định đối tượng mô tả. “Dữ liệu nghiên cứu” có thể cần metadata ở nhiều mức: toàn bộ dataset, từng file, từng biến, mẫu vật, phép đo hoặc thành phần khác. Không phải mọi trường đều phù hợp cho mọi cấp. Chẳng hạn title thường thuộc cấp dataset, trong khi tên biến, nhãn biến, đơn vị đo hay mã giá trị thiếu thuộc cấp biến.
Điểm này đặc biệt quan trọng với dữ liệu định lượng. DDI Alliance cho biết một codebook có thể chứa tên và nhãn biến, khái niệm, nhóm giá trị, mã giá trị thiếu, universe và nhiều thông tin khác cần để hiểu một dataset. Điều đó cho thấy metadata cấp dataset không thể thay thế metadata chi tiết cấp biến khi mục tiêu là phân tích hoặc tái sử dụng dữ liệu.
Research Data Alliance cũng nhấn mạnh rằng metadata chất lượng cao cần hỗ trợ nhận diện, khám phá, đặt dữ liệu vào đúng ngữ cảnh, diễn giải và tái sử dụng; đồng thời metadata scheme nên phù hợp với miền nghiên cứu và loại dữ liệu cụ thể.
Nhóm trường nhận diện và trích dẫn dữ liệu
Nếu cần một điểm chuẩn để thiết kế lớp metadata cốt lõi, DataCite Metadata Schema 4.7 là một tham chiếu hữu ích cho dữ liệu và các đầu ra nghiên cứu có khả năng được xuất bản hoặc trích dẫn. Phiên bản 4.7 được phát hành ngày 3/3/2026. Schema có 20 thuộc tính chính, trong đó 6 thuộc tính là bắt buộc đối với metadata gửi tới DataCite.
|
Trường cốt lõi |
Vai trò khi thiết kế metadata |
|
Identifier |
Định danh duy nhất tài nguyên, ưu tiên định danh bền vững khi quy trình xuất bản hỗ trợ |
|
Creator |
Xác định cá nhân hoặc tổ chức chịu trách nhiệm chính về việc tạo dữ liệu |
|
Title |
Cung cấp tên nhận biết được của dataset |
|
Publisher |
Xác định đơn vị xuất bản hoặc phát hành tài nguyên |
|
PublicationYear |
Ghi năm tài nguyên được công bố hoặc đưa vào trạng thái có thể trích dẫn |
|
ResourceType |
Xác định loại tài nguyên đang được mô tả |
Đây là bộ tối thiểu của DataCite, không phải bộ metadata tối thiểu phổ quát cho mọi nhu cầu quản trị và tái sử dụng dữ liệu. DataCite còn có 6 thuộc tính ở mức Recommended và khuyến khích sử dụng cả nhóm Mandatory lẫn Recommended để tăng khả năng tài nguyên được tìm thấy, trích dẫn và liên kết.
Trong thiết kế thực tế, các trường nhận diện cũng nên được cấu trúc đủ chi tiết. Creator chẳng hạn không nên chỉ là một chuỗi tên khó phân giải nếu hệ thống có khả năng quản lý định danh cá nhân hoặc tổ chức. Tương tự, một identifier cần được phân biệt với URL truy cập: URL có thể thay đổi theo hạ tầng, còn chức năng của định danh là giúp hệ thống xác định đúng tài nguyên qua thời gian.
Với dữ liệu có nhiều phiên bản, cần quyết định ngay identifier đang nhận diện khái niệm dataset nói chung hay một phiên bản cụ thể. Nếu bỏ qua quyết định này, người dùng có thể trích dẫn một identifier nhưng tải về nội dung đã thay đổi, làm giảm khả năng tái lập kết quả nghiên cứu.
Nhóm trường giúp tìm kiếm và hiểu đúng dữ liệu
Sau khi tài nguyên có thể được nhận diện, metadata phải giúp người khác quyết định liệu dataset có phù hợp với nhu cầu của họ hay không. DataCite 4.7 xếp Subject, Contributor, Date, RelatedIdentifier, Description và GeoLocation vào nhóm Recommended. Trong đó, DataCite đặc biệt nhấn mạnh giá trị của Description, nhất là mô tả dạng Abstract, đối với việc tìm và đánh giá tài nguyên.
Một profile cho dữ liệu nghiên cứu thường cần xem xét các trường sau:
|
Nhóm thông tin |
Trường nên xem xét |
Câu hỏi metadata phải trả lời |
|
Mô tả |
Description/Abstract |
Dataset chứa gì, phạm vi và mục đích của nó là gì |
|
Chủ đề |
Subject/Keyword |
Dữ liệu thuộc chủ đề hoặc lĩnh vực nào |
|
Thời gian |
Date, temporal coverage |
Dữ liệu được tạo, thu thập, sửa đổi hoặc bao phủ khoảng thời gian nào |
|
Không gian |
GeoLocation/spatial coverage |
Dữ liệu liên quan đến địa điểm hoặc vùng địa lý nào |
|
Ngôn ngữ |
Language |
Nội dung dữ liệu hoặc tài liệu mô tả sử dụng ngôn ngữ nào |
|
Phương pháp |
Method/collection information khi domain yêu cầu |
Dữ liệu được tạo hoặc thu thập theo quy trình nào |
|
Mức chi tiết |
Variable/sample/file metadata |
Người dùng cần hiểu những thành phần nào bên trong dataset |
Sự khác biệt giữa ngày xuất bản, ngày thu thập, ngày tạo và khoảng thời gian mà dữ liệu phản ánh không nên bị xóa bỏ bằng một trường date chung chung. Khi các khái niệm thời gian có ý nghĩa khác nhau đối với người dùng, chúng cần được biểu diễn bằng loại ngày hoặc thuộc tính riêng có ngữ nghĩa rõ ràng.
Tương tự, từ khóa tự do hữu ích nhưng không phải lúc nào cũng đủ. Khi một cộng đồng nghiên cứu đã có controlled vocabulary, thesaurus hoặc classification scheme phù hợp, việc lưu cả giá trị thuật ngữ và định danh của thuật ngữ giúp giảm tình trạng cùng một khái niệm được viết bằng nhiều cách. DataCite cho phép Subject đi kèm thông tin về subject scheme và URI của giá trị, cho thấy metadata có thể được thiết kế vượt ra ngoài chuỗi văn bản tự do.
Đối với dữ liệu khảo sát, dữ liệu bảng hoặc dữ liệu có cấu trúc biến, lớp mô tả này cần đi sâu hơn dataset-level metadata. DDI chỉ ra rằng codebook có thể mô tả tên biến, nhãn, khái niệm, categories, missing-value codes và universe. Những trường như vậy không cần áp dụng cho mọi dataset nhưng trở thành critical metadata khi người dùng phải diễn giải từng biến.
Nhóm trường hỗ trợ nguồn gốc, liên kết và tái sử dụng
Metadata phục vụ discovery chưa chắc đã đủ để tái sử dụng. Người dùng còn cần biết dataset có quan hệ với tài nguyên nào, phiên bản nào đang được xem, quyền sử dụng ra sao và những tác nhân nào tham gia quá trình tạo dữ liệu.
DataCite 4.7 cung cấp nhiều thuộc tính phục vụ lớp thông tin này. RelatedIdentifier thuộc nhóm Recommended; Version, Rights, Format, Size, FundingReference và RelatedItem thuộc nhóm Optional trong schema DataCite. Phân loại Optional ở đây chỉ mô tả nghĩa vụ trong DataCite, không có nghĩa các trường này luôn không quan trọng đối với một repository cụ thể.
Ví dụ, nếu mục tiêu của hệ thống là hỗ trợ tái sử dụng, Rights hoặc license có thể cần được nâng thành trường bắt buộc trong application profile nội bộ, dù tiêu chuẩn nền không yêu cầu. DCMI cho phép application profile đặt thêm quy tắc về trường bắt buộc, khả năng lặp và các ràng buộc giá trị; do đó profile địa phương có thể chặt hơn vocabulary hoặc schema mà nó tái sử dụng.
Các nhóm trường nên cân nhắc gồm:
|
Nhóm |
Giá trị cần quản lý |
|
Contributor |
Người hoặc tổ chức có vai trò khác với creator |
|
Version |
Phiên bản của dataset đang được mô tả |
|
Rights/License |
Quyền truy cập, giấy phép hoặc tuyên bố quyền |
|
Format |
Định dạng kỹ thuật của tài nguyên |
|
RelatedIdentifier |
Liên kết có ngữ nghĩa tới bài báo, dataset, phần mềm, dự án hoặc tài nguyên khác |
|
FundingReference |
Nguồn tài trợ liên quan |
|
Provenance |
Nguồn gốc và những bước xử lý quan trọng khi việc diễn giải dữ liệu phụ thuộc vào chúng |
Riêng quan hệ giữa các tài nguyên không nên chỉ được lưu dưới dạng một URL “liên quan”. Hệ thống cần biết quan hệ đó có nghĩa gì: dataset bổ sung cho bài báo, được tạo ra từ tài nguyên khác, là phiên bản của một tài nguyên, hay được một phần mềm cụ thể xử lý. DataCite sử dụng RelatedIdentifier cùng loại quan hệ để làm rõ ngữ nghĩa này.
Một sai lầm phổ biến là cho rằng càng bắt buộc nhiều trường thì metadata càng tốt. Trên thực tế, trường bắt buộc chỉ nên được chọn khi thiếu nó sẽ làm hỏng một chức năng đã xác định. Nếu một trường hiếm khi có giá trị hợp lệ nhưng vẫn bị bắt buộc, người nhập dữ liệu có xu hướng cung cấp giá trị hình thức hoặc không nhất quán. Vì vậy, mức Mandatory, Recommended và Optional phải phản ánh use case của profile, không chỉ phản ánh mong muốn “thu thập càng nhiều càng tốt”.
Mỗi trường metadata cần được đặc tả bằng những quy tắc nào?
Tên trường chỉ là điểm khởi đầu. Hai hệ thống đều có trường creator nhưng vẫn có thể không trao đổi metadata được nếu một bên lưu một chuỗi tự do, còn bên kia yêu cầu cấu trúc tên, identifier và affiliation.
DC Tabular Application Profiles của DCMI thể hiện rõ nguyên tắc này. Một profile có thể mô tả property, nhãn của property, tính bắt buộc, khả năng lặp, loại node hoặc datatype, ràng buộc giá trị, shape và ghi chú. Nói cách khác, metadata design phải xác định cả trường lẫn hợp đồng sử dụng trường.
Với mỗi trường, tối thiểu nên trả lời các vấn đề sau:
|
Thuộc tính thiết kế |
Nội dung cần xác định |
|
Property ID |
Định danh máy đọc được của trường, ưu tiên tái sử dụng term đã tồn tại |
|
Label |
Tên hiển thị rõ nghĩa cho người nhập và người đọc |
|
Definition |
Định nghĩa chính xác trường biểu diễn điều gì |
|
Obligation |
Mandatory, Recommended hay Optional trong profile cụ thể |
|
Cardinality |
Có được lặp không, tối thiểu và tối đa bao nhiêu giá trị |
|
Value type |
Chuỗi, số, ngày, URI, identifier hay cấu trúc phức hợp |
|
Value constraint |
Controlled vocabulary, pattern, danh sách giá trị hoặc quy tắc hợp lệ |
|
Identifier scheme |
Quy tắc định danh khi giá trị đại diện cho người, tổ chức, khái niệm hoặc tài nguyên |
|
Example/Note |
Ví dụ và hướng dẫn cho các trường hợp dễ nhập sai |
|
Validation rule |
Điều kiện phần mềm có thể kiểm tra tự động |
Ví dụ, định nghĩa một trường subject chỉ là “từ khóa” vẫn chưa đủ. Profile cần quyết định nó có được lặp không, chấp nhận free text hay controlled vocabulary, có lưu URI của thuật ngữ không và có cho phép nhiều vocabulary cùng tồn tại không. Chính các quyết định này mới tạo ra tính nhất quán.
Cardinality cũng không nên bị đồng nhất với “bắt buộc hay không”. Một trường có thể là tùy chọn nhưng khi xuất hiện lại được phép có nhiều giá trị; một trường khác có thể bắt buộc chính xác một lần. DataCite biểu diễn rõ các trường hợp 0-n, 0-1, 1-n và 1, cho thấy nghĩa vụ và khả năng lặp là hai chiều thiết kế riêng biệt.
Cuối cùng, nên ưu tiên reuse vocabulary và identifier đã được cộng đồng chấp nhận thay vì tạo một trường mới chỉ vì tên nội bộ thuận tiện hơn. Nếu cần tên hiển thị riêng, có thể giữ label nội bộ nhưng mapping nó tới property chuẩn. Cách làm này bảo toàn ngữ nghĩa trong khi vẫn đáp ứng giao diện hoặc quy trình nghiệp vụ địa phương.
Chọn chuẩn nền và kiểm thử bộ metadata trước khi áp dụng
Không có một metadata schema duy nhất tối ưu cho tất cả dữ liệu nghiên cứu. RDA đã phát triển Metadata Standards Catalog chính vì các cộng đồng cần tìm scheme phù hợp với domain và loại dữ liệu, thay vì giả định mọi dataset có cùng yêu cầu mô tả.
Có thể chọn chuẩn nền theo chức năng chính:
· DataCite phù hợp khi cần nhận diện, xuất bản, DOI, trích dẫn và liên kết đầu ra nghiên cứu; phiên bản 4.7 có 6 thuộc tính Mandatory, 6 Recommended và 8 Optional trong tổng số 20 thuộc tính chính
· Dublin Core/DCMI Terms phù hợp làm vocabulary liên ngành tương đối tổng quát; application profile của DCMI giúp bổ sung các quy tắc sử dụng và ràng buộc cần thiết
· DDI phù hợp khi nghiên cứu cần metadata chi tiết về study, file, biến, thu thập và các thành phần thường gặp trong dữ liệu khoa học xã hội, hành vi, kinh tế hoặc y tế
· Chuẩn chuyên ngành nên được ưu tiên bổ sung khi cộng đồng khoa học tương ứng đã có vocabulary hoặc schema đủ trưởng thành, thay vì ép toàn bộ ngữ nghĩa chuyên môn vào các trường tổng quát
Sau khi chọn chuẩn, nên tạo một application profile chính thức thay vì quản lý các trường bằng hiểu biết ngầm của nhóm dự án. Profile có thể là bảng mà mỗi dòng là một property và các cột mô tả definition, obligation, cardinality, datatype, vocabulary, mapping và validation rule. DCTAP được thiết kế chính xác cho kiểu biểu diễn dạng bảng này và có thể lưu dưới dạng CSV/TSV để vừa dễ đọc vừa thuận lợi cho xử lý bằng phần mềm.
Trước khi đưa profile vào vận hành, cần kiểm thử bằng dữ liệu thực: một record điển hình, một record thiếu một số thông tin và một trường hợp biên có nhiều creator, nhiều ngày, nhiều phiên bản hoặc nhiều quan hệ. Mục tiêu không chỉ là kiểm tra “form có lưu được hay không”, mà còn xem metadata xuất ra có giữ nguyên ý nghĩa khi tìm kiếm, trao đổi hoặc mapping sang chuẩn đích.
Cuối cùng, cần phân biệt validation cú pháp với validation ngữ nghĩa. Một ngày tháng có thể đúng định dạng nhưng dùng sai loại ngày; một URI có thể hợp lệ về cú pháp nhưng trỏ tới sai khái niệm; một trường creator có thể không rỗng nhưng chứa tên tổ chức trong khi hệ thống hiểu nó là cá nhân. Vì vậy, kiểm thử metadata phải bao gồm cả kiểm tra bằng máy và kiểm tra những record đại diện bởi người hiểu domain. DCMI nhấn mạnh rằng application profile phải đủ rõ về ngữ nghĩa và nhất quán nội bộ để những bên khác có thể tái sử dụng metadata.
Thiết kế metadata dữ liệu nghiên cứu vì thế không nên bắt đầu bằng câu hỏi “cần bao nhiêu trường”, mà bằng câu hỏi “người khác cần biết gì để nhận diện, tìm thấy, hiểu và tái sử dụng dữ liệu này?”. Từ đó, có thể xây dựng một lớp cốt lõi gồm định danh, creator, title, publisher, thời gian và loại tài nguyên; bổ sung mô tả, chủ đề, phạm vi, quan hệ, quyền, phiên bản, provenance và metadata chi tiết theo đặc thù dữ liệu.
Quan trọng hơn, mỗi trường phải có định nghĩa, mức nghĩa vụ, cardinality, kiểu giá trị và ràng buộc rõ ràng. DataCite, DCMI hay DDI nên được dùng làm nền để tái sử dụng ngữ nghĩa và tăng khả năng trao đổi, còn application profile cụ thể mới là nơi quyết định trường nào thực sự bắt buộc đối với hệ thống nghiên cứu đang được xây dựng.

GỬI Ý KIẾN BÌNH LUẬN

