
Cách tích hợp dữ liệu nghiên cứu từ nhiều nguồn
Mục lục
Tích hợp dữ liệu nghiên cứu không chỉ là ghép nhiều bảng thành một tập dữ liệu. Quy trình đúng phải đồng bộ cấu trúc, định nghĩa biến, đơn vị, mã hóa, khóa định danh và nguồn gốc dữ liệu trước khi phân tích, đồng thời giữ lại những khác biệt có ý nghĩa giữa các nguồn.
Một tập dữ liệu tích hợp chỉ thực sự hữu ích khi các giá trị được đặt cạnh nhau vẫn mang cùng ý nghĩa mà nhà phân tích cho rằng chúng đang mang. Hai cột cùng tên chưa chắc đo cùng một khái niệm; hai giá trị cùng bằng “1” có thể đại diện cho hai trạng thái khác nhau; cùng một biến “tuổi” có thể được ghi tại thời điểm tuyển mẫu, thời điểm khảo sát hoặc ngày nhập viện.
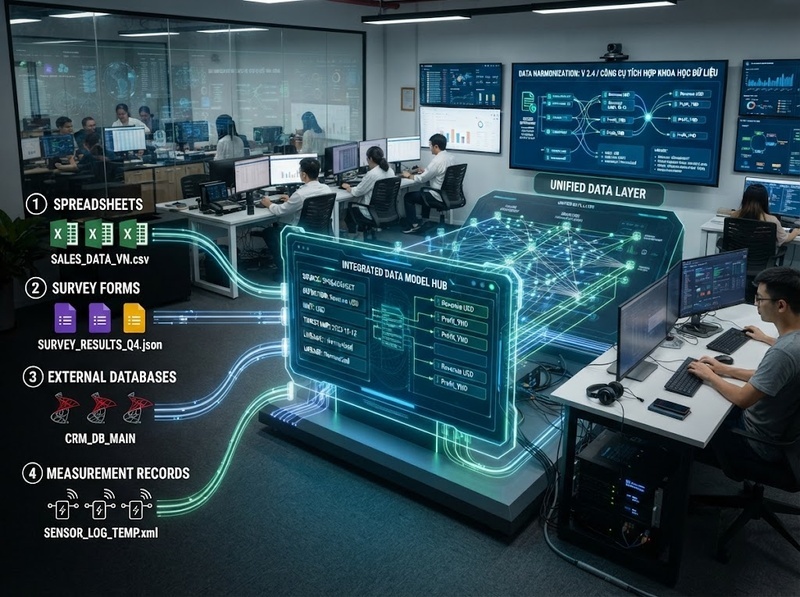
Vì vậy, tích hợp dữ liệu nghiên cứu nên được xem là quá trình hài hòa cấu trúc và ngữ nghĩa trước khi ghép dữ liệu vật lý. Thứ tự an toàn thường là: kiểm kê nguồn → mô tả metadata → xác định khái niệm chung → lập ánh xạ → chuẩn hóa biểu diễn → liên kết bản ghi → kiểm tra tính toàn vẹn → đóng băng phiên bản dùng cho phân tích. Cách làm này giữ được khả năng truy ngược từ một giá trị trong bảng phân tích về nguồn và định nghĩa ban đầu của nó.
Xác định mô hình dữ liệu chung trước khi ghép nguồn
Sai lầm phổ biến nhất là bắt đầu bằng câu hỏi “dùng join, merge hay append như thế nào?”. Đây là câu hỏi kỹ thuật xuất hiện quá sớm. Trước khi ghép, cần xác định mỗi hàng đại diện cho cái gì, mỗi cột đại diện cho khái niệm nào và một quan sát được xác định tại thời điểm nào.
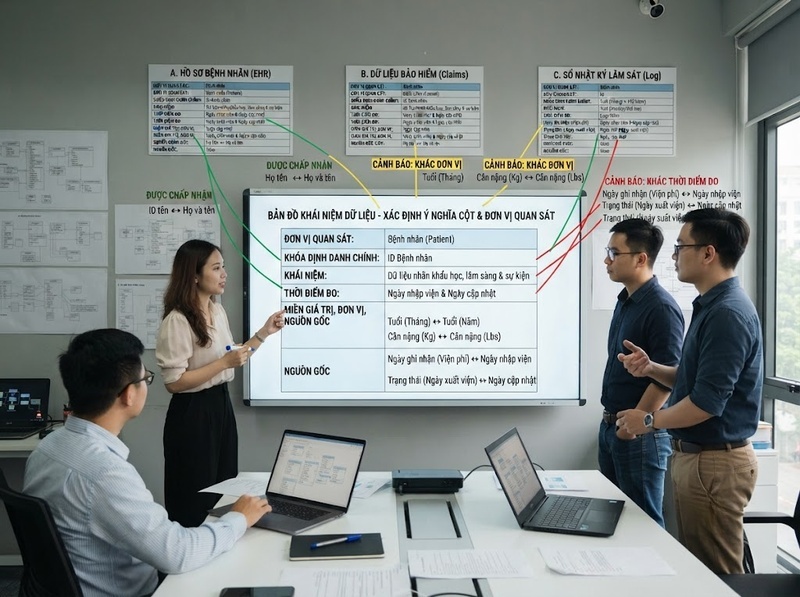
Ví dụ, ba nguồn nghiên cứu đều có trường status, nhưng một nguồn dùng nó cho tình trạng tham gia nghiên cứu, nguồn khác dùng cho tình trạng bệnh và nguồn thứ ba dùng cho trạng thái hồ sơ. Nếu chỉ đồng nhất tên cột, dữ liệu trở nên đồng nhất về hình thức nhưng sai về ngữ nghĩa.
Một mô hình chung nên xác định ít nhất:
· Đơn vị quan sát: Người, mẫu, lần khám, sự kiện hoặc cơ sở
· Định danh: Khóa nào xác định duy nhất một thực thể
· Khái niệm: Biến đang mô tả thuộc tính nào của thực thể
· Thời gian: Giá trị có hiệu lực hoặc được đo tại thời điểm nào
· Miền giá trị: Giá trị hợp lệ và ý nghĩa của từng mã
· Đơn vị đo: Đơn vị gốc và đơn vị chuẩn nếu có chuyển đổi
· Nguồn gốc: Giá trị đến từ nguồn nào và đã trải qua biến đổi gì
Đây là lớp ngữ nghĩa trung gian giữa dữ liệu nguồn và bảng phân tích. Có thể triển khai nó dưới dạng canonical data model, data dictionary hoặc metadata registry tùy quy mô dự án. ISO/IEC 11179 tiếp cận metadata theo hướng mô tả data element và các khái niệm, miền giá trị liên quan; cách tiếp cận này cho thấy lý do cần tách “khái niệm đang đo” khỏi “cách dữ liệu được biểu diễn”.
Mô hình chung không có nghĩa mọi nguồn phải bị ép thành một cấu trúc giống hệt nhau. Những khác biệt phản ánh thiết kế nghiên cứu, quần thể, công cụ đo hoặc thời điểm quan sát cần được giữ lại thay vì làm phẳng.
Kiểm kê từng nguồn bằng metadata và data dictionary
Sau khi xác định đối tượng tích hợp, cần lập hồ sơ cho từng nguồn trước khi chuyển đổi dữ liệu. Mục tiêu là biết chính xác nguồn đang chứa gì, không chỉ biết file có bao nhiêu cột.
Một data dictionary thực dụng nên ghi lại tên biến gốc, nhãn biến, định nghĩa, kiểu dữ liệu, miền giá trị, mã thiếu, đơn vị, thời điểm đo, phương pháp thu thập, khóa định danh và phiên bản nguồn. Với dữ liệu khảo sát hoặc nghiên cứu xã hội, metadata còn có thể cần mô tả câu hỏi, phương án trả lời, universe, wave và quá trình xử lý.
DDI được thiết kế để mô tả metadata của dữ liệu nghiên cứu và hỗ trợ các hoạt động như quản lý vòng đời dữ liệu, so sánh nghiên cứu và lập concordance giữa các biến. Điều này phản ánh một nguyên tắc quan trọng: khả năng tích hợp phụ thuộc nhiều vào metadata chứ không chỉ phụ thuộc định dạng CSV, Excel hay database.
Ở bước kiểm kê, cần phát hiện sớm các xung đột như:
|
Nguồn A |
Nguồn B |
Rủi ro |
|
|
|
Cùng số nhưng khác ý nghĩa |
|
|
|
Cùng tên, khác đơn vị |
|
|
|
Cùng khái niệm gần đúng, khác thời điểm |
|
|
Ô trống là thiếu |
Mã thiếu có thể bị coi thành giá trị thật |
|
|
|
Khác cấp độ định danh |
Nếu những khác biệt này chỉ được phát hiện sau khi đã ghép bảng, lỗi thường khó truy ngược hơn vì thông tin nguồn đã bị pha trộn.
Chuẩn hóa biểu diễn mà không làm thay đổi ý nghĩa
Sau khi hiểu metadata, có thể chuẩn hóa các khác biệt thuần về biểu diễn. Đây là những khác biệt mà việc chuyển đổi không làm thay đổi khái niệm được đo.
Các thao tác thường bao gồm chuẩn hóa kiểu dữ liệu, định dạng ngày giờ, timezone, đơn vị đo, encoding, cách viết danh mục, mã missing và quy tắc đặt tên. Tuy nhiên, mọi phép chuyển đổi phải tách được giá trị gốc khỏi giá trị chuẩn hóa.
Ví dụ, nếu một nguồn ghi chiều cao bằng centimet và nguồn khác bằng mét, có thể chuyển cả hai về một đơn vị chuẩn vì quan hệ chuyển đổi được xác định rõ. Nhưng nếu một nguồn dùng “thu nhập cá nhân hàng tháng” còn nguồn khác dùng “thu nhập hộ gia đình hàng năm”, việc quy đổi đơn vị tiền tệ hoặc thời gian vẫn không khiến hai biến trở thành cùng một đại lượng.
Do đó nên phân biệt ba trường hợp:
1. Khác biểu diễn nhưng cùng ngữ nghĩa: Có thể chuẩn hóa trực tiếp
2. Khái niệm tương đương có điều kiện: Chỉ hài hòa khi điều kiện tương đương được chứng minh
3. Khái niệm khác nhau: Không được hợp nhất chỉ để tạo một cột chung
Một thực hành an toàn là giữ song song trường gốc và trường chuẩn hóa, chẳng hạn weight_raw, weight_raw_unit, weight_kg. Điều này cho phép kiểm tra lại phép biến đổi mà không cần quay về file ban đầu.
Không tồn tại một ngưỡng phần trăm chuẩn hóa hay tỷ lệ missing duy nhất có thể dùng cho mọi nghiên cứu. Tiêu chí chấp nhận cần được xác định theo thiết kế nghiên cứu, nguồn dữ liệu và mục tiêu phân tích thay vì chọn một ngưỡng tùy ý.
Ánh xạ biến theo khái niệm thay vì theo tên cột
Đây là bước quyết định việc tích hợp có bảo toàn ngữ nghĩa hay không. Mỗi biến nguồn cần được ánh xạ đến biến đích dựa trên định nghĩa, không dựa đơn thuần vào tên.
Có thể xây dựng một bảng crosswalk như sau:
|
Biến nguồn |
Khái niệm nguồn |
Biến đích |
Quy tắc ánh xạ |
Trạng thái |
|
|
Ngày sinh |
|
Đổi định dạng ngày |
Tương đương |
|
|
Tuổi tròn tại khảo sát |
|
Giữ kèm ngày đo |
Tương đương có điều kiện |
|
|
Thu nhập hộ |
Không ánh xạ |
Khác khái niệm |
Tách riêng |
Điểm quan trọng là “không ánh xạ” cũng là một kết quả hợp lệ. Cố gắng ép mọi biến vào một schema duy nhất có thể làm giảm số lượng trường nhưng đồng thời làm mất thông tin về sự khác nhau giữa các nghiên cứu.
Khi hai thang đo khác nhau cùng nhằm phản ánh một cấu trúc lý thuyết, không nên mặc định quy đổi chỉ vì chúng có mục đích gần giống nhau. Cần xem xét cấu trúc thang đo, cách chấm điểm, phạm vi, thời điểm đo và điều kiện áp dụng. Trong nhiều trường hợp, giữ hai biến riêng rồi xử lý sự tương đương ở bước phân tích an toàn hơn việc hợp nhất trước.
Bảng ánh xạ cũng nên được phiên bản hóa. Khi định nghĩa biến đích thay đổi, cần biết tập dữ liệu nào được tạo bằng phiên bản mapping nào. Điều đó giúp kết quả phân tích có thể tái tạo được.
Liên kết bản ghi nhưng phải giữ provenance
Khi schema và khái niệm đã được hài hòa, dữ liệu mới nên được ghép ở cấp bản ghi. Hai tình huống chính là nối thêm quan sát cùng cấu trúc và liên kết các thuộc tính thuộc cùng một thực thể.
Nếu có khóa định danh ổn định, việc liên kết tương đối trực tiếp. Tuy nhiên, vẫn phải kiểm tra cardinality trước khi join. Một khóa được cho là “ID bệnh nhân” có thể duy nhất trong một bảng nhưng lặp trong bảng khác vì bảng thứ hai ghi nhiều lần khám. Ghép one-to-many như thể one-to-one có thể nhân bản quan sát và thay đổi trọng số dữ liệu mà không tạo lỗi kỹ thuật nào.
Nếu không có khóa chung, entity resolution có thể dựa trên nhiều thuộc tính. Nhưng khi liên kết mang tính xác suất hoặc heuristic, cần giữ:
· Các trường được sử dụng để matching
· Quy tắc hoặc mô hình matching
· Điểm tin cậy nếu có
· Trạng thái match/unmatch
· Các trường hợp được xử lý thủ công
Không nên xóa dấu vết nguồn sau khi merge. Một trường source_id, source_record_id hoặc bảng lineage riêng giúp truy lại giá trị sau tích hợp. W3C PROV mô hình hóa provenance thông qua thông tin về entity, activity và agent liên quan tới việc tạo hoặc biến đổi dữ liệu, đồng thời hỗ trợ trao đổi provenance giữa các hệ thống.
Provenance đặc biệt quan trọng khi hai nguồn cung cấp giá trị khác nhau cho cùng một thuộc tính. Nếu chỉ giữ giá trị “cuối cùng”, nhà phân tích không còn biết xung đột đã từng tồn tại.
Kiểm tra tập tích hợp trước khi cho phép phân tích
Việc pipeline chạy thành công không chứng minh dữ liệu đã được tích hợp đúng. Cần có một lớp kiểm tra độc lập sau merge để phát hiện những thay đổi do quá trình tích hợp gây ra.
Trước hết, kiểm tra tính toàn vẹn cấu trúc: số dòng trước và sau join, tính duy nhất của khóa, số bản ghi unmatched, duplicated keys và cardinality thực tế. Một phép left join được kỳ vọng giữ nguyên số thực thể nhưng lại làm số dòng tăng mạnh là dấu hiệu cần điều tra ngay.
Tiếp theo là kiểm tra phân phối. Với từng biến quan trọng, nên so sánh trước và sau tích hợp về số quan sát hợp lệ, missing, miền giá trị, giá trị nhỏ nhất/lớn nhất hoặc phân phối danh mục. Mục tiêu không phải buộc phân phối giữa các nguồn giống nhau mà phát hiện thay đổi phát sinh do chuyển đổi, thay vì khác biệt vốn có của quần thể.
Cũng cần kiểm tra tính nhất quán ngữ nghĩa. Chẳng hạn, nếu sau harmonization xuất hiện giá trị nằm ngoài miền hợp lệ, đơn vị bị trộn hoặc category không thể ánh xạ về định nghĩa chuẩn, pipeline nên đánh dấu lỗi thay vì âm thầm tiếp tục.
FAIR đặt interoperability và reusability vào nhóm nguyên tắc cốt lõi của quản trị dữ liệu, còn DDI tập trung vào metadata giúp dữ liệu nghiên cứu có thể được mô tả và tái sử dụng. Trong thực hành tích hợp, điều này có nghĩa bảng cuối không nên đứng độc lập khỏi metadata và lịch sử biến đổi của nó.
Cuối cùng, nên tạo một phiên bản dữ liệu phân tích bất biến kèm phiên bản code, mapping và metadata tương ứng. Khi logic tích hợp thay đổi, hãy sinh phiên bản mới thay vì ghi đè. Nhờ vậy, kết quả thống kê có thể được gắn với chính xác tập dữ liệu đã tạo ra nó.
Một quy trình tích hợp dữ liệu nghiên cứu tốt không bắt đầu bằng việc ghép càng nhiều nguồn càng tốt. Nó bắt đầu bằng việc xác định điều gì thực sự tương đương giữa các nguồn.
Thứ tự thực hành an toàn là: mô hình hóa khái niệm → kiểm kê metadata → chuẩn hóa biểu diễn → lập crosswalk → liên kết bản ghi → lưu provenance → kiểm tra sau tích hợp. Chỉ khi các bước này hoàn tất, tập dữ liệu mới nên được chuyển sang phân tích.
Nguyên tắc quan trọng nhất là không đánh đổi ngữ nghĩa để lấy một bảng dữ liệu trông đồng nhất. Nếu hai biến không thực sự đo cùng một thứ, giữ chúng tách biệt thường chính xác hơn việc ép chúng vào cùng một cột.
Có nên chuẩn hóa tất cả dữ liệu về cùng một schema?
Không. Chỉ nên chuẩn hóa những thành phần tương đương về khái niệm hoặc có phép chuyển đổi được xác định rõ. Khác biệt mang ý nghĩa nghiên cứu cần được giữ lại.
Khi nào hai biến có thể được gộp thành một?
Khi định nghĩa, đơn vị quan sát, thời điểm đo, miền giá trị và ý nghĩa của chúng tương đương hoặc đã có quy tắc harmonization có căn cứ. Tên cột giống nhau không đủ để kết luận.
Nên xử lý dữ liệu thiếu trước hay sau khi tích hợp?
Mã biểu diễn missing cần được chuẩn hóa trước khi ghép để tránh coi mã như 99, 999 hoặc chuỗi đặc biệt là giá trị thật. Việc xử lý thống kê đối với missing, chẳng hạn loại bỏ hoặc imputing, thường thuộc giai đoạn phân tích sau khi dữ liệu đã được tích hợp và kiểm tra.
Vì sao cần giữ dữ liệu gốc sau khi đã chuẩn hóa?
Dữ liệu gốc cho phép kiểm tra phép chuyển đổi, điều tra sai lệch và tái tạo pipeline. Nếu chỉ giữ giá trị đã chuẩn hóa, nhiều lỗi tích hợp sẽ không còn đủ thông tin để truy nguyên.

GỬI Ý KIẾN BÌNH LUẬN

