
Công nghệ làm sạch dữ liệu nghiên cứu hoạt động thế nào?
Mục lục
- Công nghệ làm sạch dữ liệu nghiên cứu phát hiện lỗi bằng cách nào?
- Những loại lỗi dữ liệu nghiên cứu nào có thể được công nghệ xử lý?
- Công nghệ sử dụng những phương pháp nào để sửa lỗi dữ liệu?
- Vai trò của trí tuệ nhân tạo trong làm sạch dữ liệu nghiên cứu
- Những giới hạn cần lưu ý khi sử dụng công nghệ làm sạch dữ liệu nghiên cứu
- Công nghệ làm sạch dữ liệu giúp nâng cao chất lượng nghiên cứu như thế nào?
Công nghệ làm sạch dữ liệu nghiên cứu giúp tự động phát hiện dữ liệu sai lệch, thiếu hụt, trùng lặp và không nhất quán, từ đó nâng cao độ tin cậy của kết quả phân tích
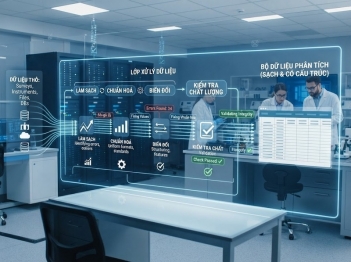
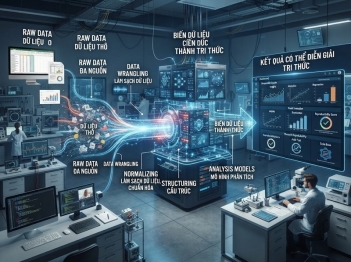
Công nghệ làm sạch dữ liệu nghiên cứu hoạt động bằng cách kết hợp các phương pháp tự động hóa, thuật toán phân tích dữ liệu và quy tắc kiểm tra chất lượng để phát hiện, đánh giá và xử lý các lỗi xuất hiện trong tập dữ liệu nghiên cứu
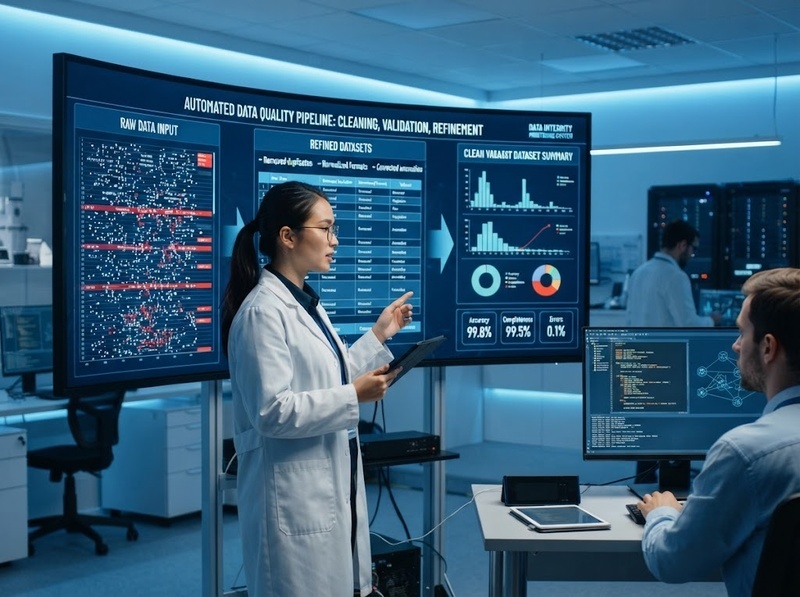
Trong nghiên cứu khoa học, dữ liệu đầu vào có thể bị ảnh hưởng bởi nhiều nguyên nhân như nhập liệu sai, thiếu thông tin, định dạng không đồng nhất, dữ liệu ngoại lai hoặc lỗi trong quá trình thu thập. Nếu không được xử lý, các vấn đề này có thể làm sai lệch kết quả phân tích và giảm độ tin cậy của nghiên cứu
Công nghệ làm sạch dữ liệu không chỉ xóa bỏ lỗi đơn giản mà còn giúp nhà nghiên cứu hiểu nguồn gốc của lỗi, xác định mức độ ảnh hưởng và lựa chọn phương án xử lý phù hợp
Công nghệ làm sạch dữ liệu nghiên cứu phát hiện lỗi bằng cách nào?
Công nghệ làm sạch dữ liệu nghiên cứu thường bắt đầu bằng quá trình kiểm tra toàn diện để nhận diện các điểm bất thường trong tập dữ liệu
Các hệ thống làm sạch dữ liệu có thể sử dụng:
· Quy tắc kiểm tra dữ liệu để phát hiện giá trị không hợp lệ
· Thuật toán so sánh để tìm bản ghi trùng lặp
· Phân tích thống kê để nhận diện dữ liệu ngoại lai
· Mô hình học máy để phát hiện mẫu dữ liệu bất thường
· Kiểm tra tính nhất quán giữa các biến hoặc nguồn dữ liệu khác nhau
Ví dụ, trong một nghiên cứu khảo sát, hệ thống có thể phát hiện một người tham gia được nhập tuổi là 250, từ đó đánh dấu đây là dữ liệu cần xem xét thay vì đưa trực tiếp vào phân tích
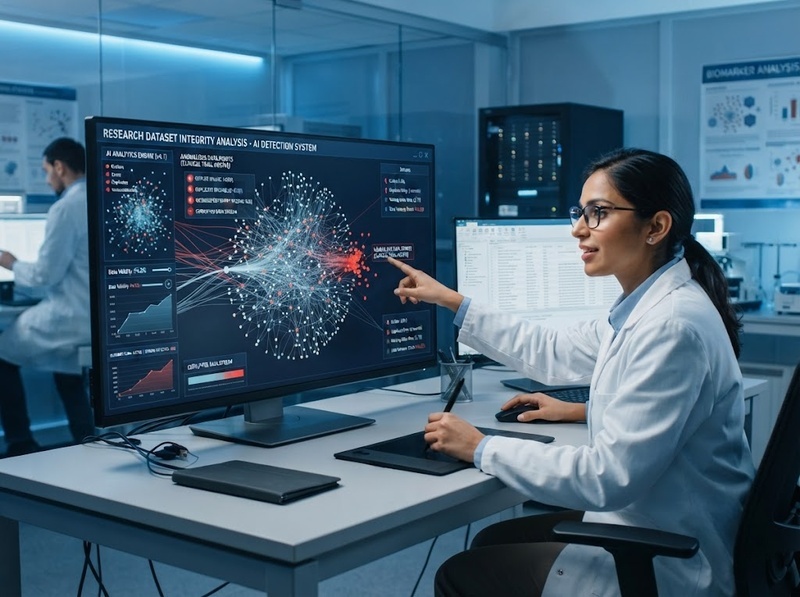
Cơ chế quan trọng của công nghệ này là không chỉ tìm kiếm lỗi theo từ khóa hoặc điều kiện cố định mà còn đánh giá mối quan hệ giữa các dữ liệu để phát hiện những sai lệch khó nhận biết bằng phương pháp thủ công
Những loại lỗi dữ liệu nghiên cứu nào có thể được công nghệ xử lý?
Công nghệ làm sạch dữ liệu có thể xử lý nhiều nhóm lỗi phổ biến trong quy trình nghiên cứu
Lỗi thiếu dữ liệu
Dữ liệu thiếu xảy ra khi một hoặc nhiều trường thông tin không có giá trị
Công nghệ có thể:
· Xác định tỷ lệ dữ liệu bị thiếu
· Phân tích mức độ ảnh hưởng của phần dữ liệu thiếu
· Đề xuất phương án loại bỏ, bổ sung hoặc thay thế dữ liệu phù hợp
Việc xử lý dữ liệu thiếu cần dựa trên bản chất nghiên cứu vì không phải mọi giá trị thiếu đều có thể được thay thế tự động
Lỗi không nhất quán
Lỗi không nhất quán xuất hiện khi dữ liệu có cách biểu diễn khác nhau nhưng cùng phản ánh một đối tượng
Ví dụ:
· Một nhóm dữ liệu ghi “Nam” và “M”
· Ngày tháng sử dụng nhiều định dạng khác nhau
· Đơn vị đo không đồng nhất giữa các nguồn
Công nghệ làm sạch dữ liệu giúp chuẩn hóa các dạng biểu diễn này để dữ liệu có thể được phân tích chính xác hơn
Dữ liệu trùng lặp
Trong các nghiên cứu sử dụng nhiều nguồn dữ liệu, một đối tượng có thể xuất hiện nhiều lần
Thuật toán phát hiện trùng lặp có thể so sánh:
· Mã định danh
· Thông tin mô tả
· Mối quan hệ giữa các trường dữ liệu
Sau đó hệ thống xác định bản ghi cần giữ lại hoặc hợp nhất
Dữ liệu ngoại lai
Dữ liệu ngoại lai là những giá trị khác biệt đáng kể so với xu hướng chung của tập dữ liệu
Công nghệ có thể sử dụng phương pháp thống kê hoặc mô hình học máy để phát hiện các điểm bất thường
Tuy nhiên, dữ liệu ngoại lai không luôn là lỗi. Trong một số nghiên cứu, chính những giá trị khác biệt này có thể mang ý nghĩa khoa học quan trọng
Công nghệ sử dụng những phương pháp nào để sửa lỗi dữ liệu?
Sau khi phát hiện lỗi, hệ thống làm sạch dữ liệu cần lựa chọn cách xử lý phù hợp với từng trường hợp
Các phương pháp phổ biến gồm:
· Chuẩn hóa định dạng dữ liệu
· Loại bỏ bản ghi sai hoặc không cần thiết
· Điền bổ sung dữ liệu thiếu theo phương pháp thống kê
· Hợp nhất các bản ghi tương đồng
· Chuyển đổi dữ liệu về cùng một chuẩn phân tích
Đối với các nghiên cứu phức tạp, công nghệ có thể kết hợp trí tuệ nhân tạo để đưa ra dự đoán về dữ liệu phù hợp dựa trên các mẫu đã tồn tại
Tuy nhiên, việc tự động sửa dữ liệu luôn cần có bước đánh giá của nhà nghiên cứu vì một thay đổi không phù hợp có thể làm mất đi thông tin quan trọng
Vai trò của trí tuệ nhân tạo trong làm sạch dữ liệu nghiên cứu
Trí tuệ nhân tạo mở rộng khả năng của công nghệ làm sạch dữ liệu bằng cách phát hiện các mối quan hệ phức tạp mà phương pháp truyền thống khó nhận biết
AI có thể hỗ trợ:
· Nhận diện mẫu lỗi lặp lại trong dữ liệu lớn
· Dự đoán giá trị có khả năng bị sai
· Phân loại mức độ nghiêm trọng của lỗi
· Học từ các lần xử lý trước để cải thiện kết quả
Ví dụ, trong nghiên cứu y sinh, hệ thống AI có thể phát hiện các kết quả xét nghiệm bất thường khi chúng không chỉ dựa trên một giá trị riêng lẻ mà còn xem xét mối liên hệ với nhiều chỉ số khác
Tuy nhiên, AI không thay thế hoàn toàn chuyên gia nghiên cứu. Vai trò chính của AI là hỗ trợ phát hiện và xử lý dữ liệu hiệu quả hơn
Những giới hạn cần lưu ý khi sử dụng công nghệ làm sạch dữ liệu nghiên cứu
Mặc dù công nghệ giúp cải thiện chất lượng dữ liệu, quá trình làm sạch vẫn có những giới hạn nhất định
Một số vấn đề cần lưu ý:
· Không phải lỗi dữ liệu nào cũng có thể phát hiện tự động
· Dữ liệu bị sai do thiết kế nghiên cứu có thể cần đánh giá chuyên môn
· Việc thay thế dữ liệu thiếu có thể tạo ra sai lệch nếu lựa chọn phương pháp không phù hợp
· Thuật toán có thể đưa ra kết quả không chính xác nếu dữ liệu huấn luyện không phù hợp
Vì vậy, quy trình làm sạch dữ liệu hiệu quả thường kết hợp giữa công nghệ tự động và kiểm tra của nhà nghiên cứu
Công nghệ làm sạch dữ liệu giúp nâng cao chất lượng nghiên cứu như thế nào?
Công nghệ làm sạch dữ liệu tạo ra giá trị không chỉ ở việc sửa lỗi mà còn giúp cải thiện toàn bộ quy trình nghiên cứu
Những lợi ích chính gồm:
· Tăng độ chính xác của kết quả phân tích
· Giảm thời gian xử lý dữ liệu thủ công
· Hạn chế sai sót do con người
· Tăng khả năng tái lập nghiên cứu
· Cải thiện khả năng quản lý dữ liệu trong các dự án lớn
Khi dữ liệu đầu vào có chất lượng cao hơn, các mô hình phân tích, thống kê và dự báo cũng có cơ sở đáng tin cậy hơn để đưa ra kết luận
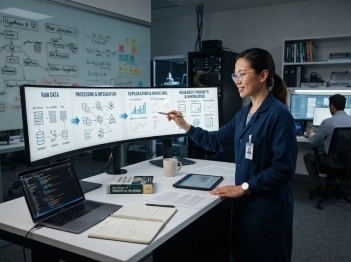
Công nghệ làm sạch dữ liệu nghiên cứu hoạt động thông qua chuỗi bước gồm phát hiện lỗi, phân tích nguyên nhân, xử lý dữ liệu và kiểm tra lại chất lượng sau xử lý. Các công nghệ như thuật toán thống kê, học máy và trí tuệ nhân tạo giúp mở rộng khả năng xử lý những tập dữ liệu lớn và phức tạp
Tuy nhiên, công nghệ chỉ là công cụ hỗ trợ. Quyết định cuối cùng về cách xử lý dữ liệu vẫn cần dựa trên kiến thức chuyên môn, mục tiêu nghiên cứu và nguyên tắc khoa học để đảm bảo kết quả có độ tin cậy cao
Hỏi đáp về công nghệ làm sạch dữ liệu nghiên cứu
Công nghệ làm sạch dữ liệu nghiên cứu có thay thế hoàn toàn con người không?
Không. Công nghệ có thể tự động phát hiện và xử lý nhiều lỗi dữ liệu nhưng vẫn cần nhà nghiên cứu đánh giá các trường hợp phức tạp và quyết định phương án xử lý phù hợp
Vì sao cần làm sạch dữ liệu trước khi phân tích nghiên cứu?
Làm sạch dữ liệu giúp giảm sai lệch, tăng độ chính xác của kết quả và đảm bảo các kết luận nghiên cứu được xây dựng trên nguồn dữ liệu đáng tin cậy
Trí tuệ nhân tạo có thể tự sửa mọi lỗi dữ liệu không?
Không. AI có thể hỗ trợ phát hiện và đề xuất xử lý lỗi nhưng không phải lúc nào cũng hiểu được ý nghĩa khoa học của dữ liệu nếu thiếu bối cảnh nghiên cứu
Làm sạch dữ liệu có làm mất thông tin quan trọng không?
Có thể xảy ra nếu xử lý không đúng cách. Vì vậy, mọi thay đổi dữ liệu cần được kiểm tra để đảm bảo không loại bỏ những thông tin có giá trị nghiên cứu

GỬI Ý KIẾN BÌNH LUẬN

