
Cách phát hiện dữ liệu bất thường bằng công nghệ
Mục lục
- Phát hiện dữ liệu bất thường dựa trên nguyên lý nào?
- Phương pháp thống kê phát hiện dữ liệu bất thường như thế nào?
- Học máy phát hiện bất thường trong dữ liệu nhiều chiều ra sao?
- Dữ liệu chuỗi thời gian cần phát hiện bất thường theo cách nào?
- Khi nào cần dùng học sâu để nhận diện bất thường?
- Làm thế nào chọn đúng phương pháp phát hiện dữ liệu bất thường?
Phát hiện dữ liệu bất thường bằng công nghệ phân tích dựa trên các phương pháp thống kê, học máy, phân tích chuỗi thời gian và mô hình học sâu. Hiệu quả phát hiện phụ thuộc vào cấu trúc dữ liệu, loại bất thường, ngưỡng cảnh báo và cách kiểm chứng kết quả.
Dữ liệu bất thường là các quan sát có đặc điểm khác đáng kể so với cấu trúc hoặc hành vi được xem là bình thường của tập dữ liệu. Công nghệ phân tích không chỉ tìm những giá trị “quá lớn” hoặc “quá nhỏ”, mà còn có thể nhận diện những điểm dữ liệu bất thường do sai khác về phân bố, mật độ, mối quan hệ giữa nhiều biến hoặc hành vi theo thời gian.
Vì vậy, không tồn tại một thuật toán duy nhất phù hợp với mọi bài toán. Phương pháp phát hiện cần được lựa chọn theo loại dữ liệu, mức độ phức tạp của quan hệ giữa các biến, sự tồn tại của dữ liệu nhãn và đặc điểm của loại bất thường cần tìm.
Về nguyên lý, hệ thống phân tích thường thực hiện ba việc: xây dựng hình ảnh về trạng thái bình thường, đo mức độ lệch của từng quan sát so với trạng thái đó và áp dụng ngưỡng hoặc quy tắc quyết định để xác định điểm cần kiểm tra.
Phát hiện dữ liệu bất thường dựa trên nguyên lý nào?
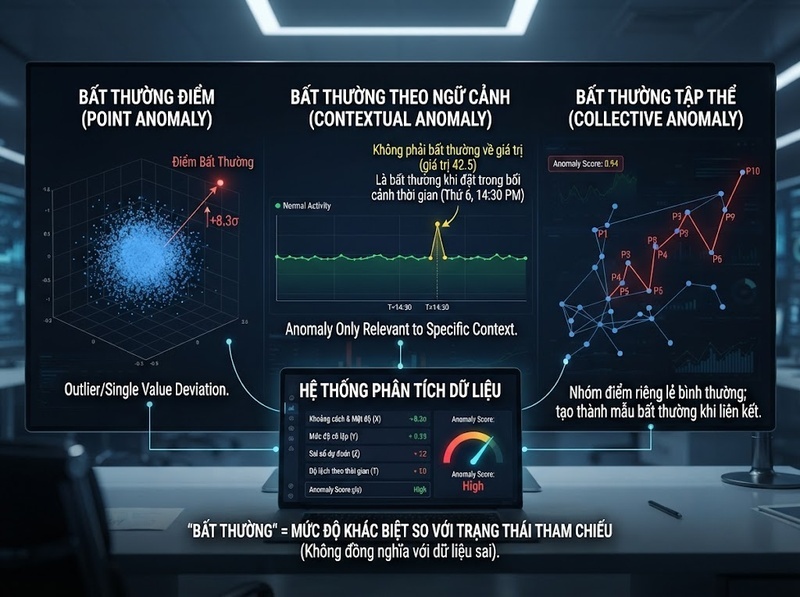
Bản chất của phát hiện bất thường là đo xem một quan sát có “khác thường đủ mức” so với dữ liệu tham chiếu hay không. Điểm khác biệt có thể xuất hiện dưới nhiều hình thức.
Một point anomaly xảy ra khi một quan sát riêng lẻ khác rõ rệt so với phần còn lại. Ví dụ, phần lớn giao dịch có giá trị từ vài trăm nghìn đến vài triệu đồng nhưng xuất hiện một giao dịch hàng trăm triệu đồng.
Contextual anomaly phức tạp hơn vì một giá trị chỉ bất thường trong một bối cảnh cụ thể. Lượng truy cập 20.000 lượt mỗi giờ có thể bình thường vào giờ cao điểm nhưng bất thường vào lúc 3 giờ sáng.
Collective anomaly xuất hiện khi từng điểm riêng lẻ có vẻ hợp lý nhưng một chuỗi hoặc một nhóm điểm tạo thành hành vi bất thường. Đây là trường hợp thường gặp trong dữ liệu cảm biến, lưu lượng mạng hoặc chuỗi giao dịch.
Công nghệ phân tích phát hiện các trường hợp này thông qua một hoặc nhiều tín hiệu:
· Khoảng cách của một quan sát tới trung tâm phân bố
· Mật độ dữ liệu xung quanh quan sát
· Mức độ cô lập của quan sát khỏi phần còn lại
· Sai số giữa giá trị quan sát và giá trị mô hình dự đoán
· Sự thay đổi bất thường của dữ liệu theo thời gian
· Quan hệ không nhất quán giữa nhiều thuộc tính
· Khả năng một quan sát thuộc về phân bố bình thường
Điểm quan trọng là bất thường không đồng nghĩa với sai dữ liệu. Một điểm ngoại lệ có thể do lỗi nhập liệu, lỗi cảm biến hoặc lỗi hệ thống, nhưng cũng có thể phản ánh một sự kiện thực sự hiếm gặp. Vì vậy, thuật toán phát hiện thường tạo ra tín hiệu hoặc điểm bất thường; việc kết luận nguyên nhân cần thêm ngữ cảnh nghiệp vụ.
Phương pháp thống kê phát hiện dữ liệu bất thường như thế nào?
Phương pháp thống kê phù hợp khi cấu trúc dữ liệu tương đối đơn giản và có thể mô tả bằng các đặc trưng như trung bình, độ lệch chuẩn, trung vị hoặc phân vị.
Z-score đo khoảng cách so với giá trị trung bình
Z-score chuẩn hóa khoảng cách của một giá trị so với trung bình theo số đơn vị độ lệch chuẩn:
z = (x − μ) / σ
Trong đó, x là giá trị cần kiểm tra, μ là trung bình và σ là độ lệch chuẩn.
Một quy tắc thực hành phổ biến là kiểm tra kỹ các quan sát có |z| > 3. Nếu dữ liệu thực sự gần phân phối chuẩn, phần lớn quan sát sẽ nằm trong khoảng ba độ lệch chuẩn quanh trung bình.
Tuy nhiên, đây không phải ngưỡng bất thường phổ quát. Z-score nhạy với chính những giá trị ngoại lệ mà nó đang cố phát hiện vì trung bình và độ lệch chuẩn đều có thể bị kéo lệch bởi các điểm cực đoan. Phương pháp cũng kém phù hợp khi dữ liệu lệch mạnh hoặc có nhiều đỉnh phân bố.
IQR sử dụng phân vị để giảm ảnh hưởng của điểm cực đoan
Interquartile Range được tính bằng:
IQR = Q3 − Q1
Một quy tắc thường dùng đánh dấu các giá trị nằm ngoài:
Q1 − 1,5 × IQR
hoặc:
Q3 1,5 × IQR
Khác với Z-score, IQR dựa trên phân vị nên ít chịu tác động của các giá trị cực đoan. Đây thường là lựa chọn phù hợp hơn khi dữ liệu lệch hoặc không thể giả định phân phối chuẩn.
Điểm hạn chế là cả Z-score và IQR chủ yếu phát hiện bất thường theo từng biến. Một bản ghi có thể hoàn toàn bình thường trên từng thuộc tính riêng nhưng trở nên bất thường khi xét sự kết hợp giữa nhiều thuộc tính. Khi đó cần phương pháp đa biến hoặc học máy.
Học máy phát hiện bất thường trong dữ liệu nhiều chiều ra sao?
Khi dữ liệu có nhiều biến hoặc mối quan hệ giữa các biến phức tạp, thuật toán học máy có thể xây dựng ranh giới về trạng thái bình thường mà không cần phụ thuộc vào một quy tắc thống kê duy nhất.
Isolation Forest tìm các điểm dễ bị cô lập
Isolation Forest dựa trên một ý tưởng khác với nhiều phương pháp truyền thống: thay vì mô hình hóa trực tiếp dữ liệu bình thường, thuật toán liên tục chia không gian dữ liệu bằng các điều kiện ngẫu nhiên.
Một quan sát khác biệt rõ rệt thường cần ít lần phân chia hơn để bị tách khỏi các quan sát còn lại. Vì vậy, đường dẫn cô lập ngắn trở thành tín hiệu cho thấy quan sát có khả năng bất thường cao.
Phương pháp này đặc biệt hữu ích khi:
· Dữ liệu có nhiều thuộc tính
· Không có nhãn đầy đủ về bất thường
· Tập dữ liệu tương đối lớn
· Cần xếp hạng các quan sát theo mức độ bất thường
Tuy nhiên, Isolation Forest vẫn cần một tiêu chí để quyết định điểm số nào đủ cao để tạo cảnh báo. Nếu đặt tỷ lệ bất thường dự kiến hoặc ngưỡng quá thấp, hệ thống có thể tạo nhiều cảnh báo giả; đặt quá cao lại có thể bỏ sót sự kiện quan trọng.
Local Outlier Factor đánh giá mật độ cục bộ
Local Outlier Factor, thường viết tắt là LOF, so sánh mật độ của một điểm với mật độ của các điểm lân cận.
Nếu một quan sát nằm trong khu vực có mật độ thấp hơn đáng kể so với những điểm gần nó, quan sát đó có thể được xem là bất thường.
Cơ chế cục bộ này có lợi khi tập dữ liệu chứa nhiều cụm với mật độ khác nhau. Một quy tắc toàn cục có thể xem một cụm thưa là bất thường, trong khi LOF có khả năng đánh giá từng điểm theo môi trường lân cận của chính nó.
Đổi lại, kết quả phụ thuộc đáng kể vào cách xác định hàng xóm và thước đo khoảng cách. Nếu các biến có thang đo rất khác nhau nhưng không được chuẩn hóa, khoảng cách có thể bị chi phối bởi một vài thuộc tính.
One-Class SVM tạo ranh giới cho dữ liệu bình thường
One-Class SVM học một vùng trong không gian đặc trưng chứa phần lớn các quan sát được xem là bình thường. Những điểm nằm ngoài vùng này được xem là ứng viên bất thường.
Phương pháp có thể mô hình hóa ranh giới phi tuyến thông qua kernel, vì vậy hữu ích khi vùng dữ liệu bình thường không có hình dạng đơn giản.
Nhược điểm là mô hình có thể nhạy với lựa chọn tham số, cách chuẩn hóa dữ liệu và tỷ lệ nhiễu trong tập huấn luyện. Với dữ liệu rất lớn, chi phí tính toán cũng có thể trở thành yếu tố cần cân nhắc.
Phân cụm phát hiện điểm không thuộc cấu trúc chính
Các thuật toán clustering có thể hỗ trợ phát hiện bất thường bằng cách xác định những quan sát:
· Nằm rất xa tâm cụm
· Thuộc cụm có số lượng quan sát rất nhỏ
· Không được gán vào cụm mật độ đủ lớn
· Có cấu trúc khác rõ rệt so với các nhóm chính
Ví dụ, với DBSCAN, các điểm không thuộc vùng mật độ đạt yêu cầu có thể được đánh dấu là noise. Tuy nhiên, “noise” của thuật toán không tự động đồng nghĩa với bất thường nghiệp vụ. Nếu tham số mật độ được thiết lập không phù hợp, các quan sát hợp lệ vẫn có thể bị tách ra.
Dữ liệu chuỗi thời gian cần phát hiện bất thường theo cách nào?
Dữ liệu theo thời gian không thể chỉ được phân tích như một tập các giá trị độc lập. Giá trị ở thời điểm hiện tại thường phụ thuộc vào xu hướng, chu kỳ, mùa vụ và những thời điểm trước đó.
Một giá trị cao chưa chắc bất thường nếu nó xuất hiện đúng thời điểm hệ thống thường đạt đỉnh. Ngược lại, một giá trị nằm trong phạm vi lịch sử vẫn có thể bất thường nếu xuất hiện sai thời điểm.
Phân tích chuỗi thời gian thường xây dựng mức kỳ vọng của dữ liệu trước, sau đó đo phần dư:
Residual = Actual − Expected
Nếu phần dư vượt quá ngưỡng được thiết kế, hệ thống có thể phát cảnh báo.
Giá trị kỳ vọng có thể được xây dựng từ:
· Trung bình trượt
· Độ lệch chuẩn trượt
· Mô hình xu hướng
· Thành phần mùa vụ
· Mô hình dự báo
· Phân bố của phần dư lịch sử
Ví dụ, thay vì cảnh báo khi số giao dịch vượt một con số cố định, hệ thống có thể so sánh số giao dịch thực tế lúc 10 giờ sáng thứ Hai với mức thông thường của chính khung thời gian đó.
Đây là khác biệt quan trọng giữa ngưỡng tĩnh và ngưỡng động. Ngưỡng tĩnh dễ triển khai nhưng khó thích nghi khi hành vi dữ liệu thay đổi. Ngưỡng động có thể phản ánh xu hướng và mùa vụ tốt hơn nhưng phụ thuộc vào chất lượng của mô hình nền.
Một vấn đề khác là concept drift: hành vi được xem là bình thường có thể thay đổi theo thời gian. Nếu mô hình không được cập nhật, trạng thái mới hợp lệ có thể liên tục bị gắn nhãn bất thường.
Khi nào cần dùng học sâu để nhận diện bất thường?
Học sâu thường có giá trị khi dữ liệu có số chiều lớn, cấu trúc phi tuyến phức tạp hoặc tồn tại quan hệ khó mô tả bằng các đặc trưng thủ công.
Autoencoder là một cách tiếp cận phổ biến. Mô hình được huấn luyện để nén rồi tái tạo dữ liệu đầu vào. Nếu chủ yếu được học từ dữ liệu bình thường, nó có xu hướng tái tạo tốt những cấu trúc quen thuộc.
Sai số tái tạo có thể được tính dưới dạng:
Reconstruction Error = khoảng cách giữa dữ liệu gốc và dữ liệu tái tạo
Quan sát có sai số tái tạo lớn hơn ngưỡng được xem là ứng viên bất thường.
Cơ chế này phù hợp khi bất thường làm phá vỡ cấu trúc nhiều chiều mà mô hình đã học. Chẳng hạn, từng thông số cảm biến có thể vẫn nằm trong giới hạn cho phép nhưng tổ hợp giữa nhiệt độ, áp suất, dòng điện và độ rung lại không giống trạng thái vận hành bình thường.
Tuy nhiên, mô hình phức tạp không mặc nhiên cho kết quả tốt hơn. Học sâu thường đòi hỏi:
· Lượng dữ liệu đủ lớn để học cấu trúc bình thường
· Quy trình huấn luyện và hiệu chỉnh mô hình
· Cách xác định ngưỡng sai số tái tạo
· Kiểm soát hiện tượng mô hình học luôn cả dữ liệu bất thường
· Hạ tầng tính toán và giám sát phù hợp
Nếu dữ liệu chỉ gồm vài biến và bất thường có thể nhận diện rõ bằng IQR hoặc quy tắc nghiệp vụ, sử dụng mạng neural có thể làm tăng độ phức tạp mà không tạo thêm giá trị tương ứng.
Làm thế nào chọn đúng phương pháp phát hiện dữ liệu bất thường?
Lựa chọn thuật toán nên bắt đầu từ bản chất của dữ liệu và loại sai lệch cần phát hiện, thay vì bắt đầu từ thuật toán đang phổ biến.
Nếu dữ liệu một chiều, phân bố tương đối ổn định và mục tiêu là tìm các giá trị cực đoan, Z-score hoặc IQR có thể đủ.
Nếu bất thường chỉ thể hiện khi xét đồng thời nhiều thuộc tính, các phương pháp như Isolation Forest, LOF, One-Class SVM hoặc mô hình đa biến thường phù hợp hơn.
Nếu dữ liệu có thứ tự thời gian, xu hướng hoặc mùa vụ, cần đưa yếu tố thời gian vào mô hình thay vì áp dụng một ngưỡng cố định trên toàn bộ tập dữ liệu.
Nếu dữ liệu rất nhiều chiều và chứa quan hệ phi tuyến phức tạp, autoencoder hoặc các mô hình biểu diễn học được có thể được cân nhắc.
Việc lựa chọn cũng phụ thuộc vào tình trạng dữ liệu nhãn.
Khi có đủ ví dụ đã được xác nhận là bình thường và bất thường, bài toán có thể được triển khai như một bài toán phân loại có giám sát. Khi hầu như không có nhãn bất thường, các phương pháp unsupervised hoặc semi-supervised trở nên quan trọng hơn.
Ngưỡng cảnh báo phải được hiệu chỉnh theo rủi ro thực tế
Điểm bất thường do mô hình tạo ra thường là một giá trị liên tục. Vì vậy, doanh nghiệp vẫn phải quyết định mức nào sẽ kích hoạt cảnh báo.
Ngưỡng thấp có thể tăng khả năng phát hiện nhưng đồng thời tạo thêm false positive. Ngưỡng cao giảm số cảnh báo nhưng tăng nguy cơ bỏ sót bất thường.
Không nên mặc định một tỷ lệ như 1%, 5% hay một điểm số cố định là chuẩn cho mọi hệ thống. Ngưỡng cần được hiệu chỉnh bằng dữ liệu lịch sử, chi phí của cảnh báo sai và hậu quả của việc bỏ sót sự kiện.
Hiệu quả phải được kiểm chứng bằng chỉ số phù hợp
Nếu có dữ liệu nhãn, việc đánh giá nên dựa trên ma trận nhầm lẫn thay vì chỉ nhìn vào accuracy.
Các chỉ số thường có ý nghĩa gồm:
· Precision: Trong các trường hợp được cảnh báo, bao nhiêu trường hợp thực sự bất thường
· Recall: Trong toàn bộ bất thường thực tế, hệ thống phát hiện được bao nhiêu
· F1-score: Cân bằng giữa Precision và Recall
· Precision-Recall curve: Đánh giá sự đánh đổi giữa phát hiện đúng và cảnh báo sai khi thay đổi ngưỡng
Accuracy có thể gây hiểu nhầm khi bất thường rất hiếm. Nếu 99,9% dữ liệu là bình thường, một hệ thống luôn dự đoán “bình thường” vẫn có accuracy 99,9% nhưng hoàn toàn không phát hiện được bất thường.
Khi chưa có đủ nhãn, cần bổ sung đánh giá bằng chuyên gia, kiểm tra mẫu cảnh báo, backtesting trên sự kiện lịch sử hoặc đối chiếu với các quy tắc nghiệp vụ đã biết.
Phát hiện dữ liệu bất thường bằng công nghệ phân tích thực chất là quá trình xây dựng mô hình của trạng thái bình thường rồi đo mức độ sai lệch của dữ liệu mới so với mô hình đó. Phương pháp thống kê như Z-score và IQR phù hợp với cấu trúc đơn giản; Isolation Forest, LOF, One-Class SVM và clustering hỗ trợ dữ liệu nhiều chiều; mô hình chuỗi thời gian xử lý xu hướng và mùa vụ; còn autoencoder phù hợp với những cấu trúc phi tuyến phức tạp.
Yếu tố quyết định không phải thuật toán nào “mạnh nhất”, mà là phương pháp nào phản ánh đúng loại bất thường cần tìm. Một hệ thống đáng tin cậy còn phải có ngưỡng cảnh báo được hiệu chỉnh, dữ liệu đầu vào phù hợp, cơ chế kiểm chứng kết quả và khả năng cập nhật khi hành vi bình thường thay đổi.
Hỏi đáp về phát hiện dữ liệu bất thường
Dữ liệu bất thường có phải luôn là dữ liệu sai không?
Không. Bất thường chỉ cho biết một quan sát khác đáng kể so với trạng thái tham chiếu. Nó có thể là lỗi dữ liệu, nhưng cũng có thể là một sự kiện hiếm nhưng hoàn toàn có thật. Vì vậy, kết quả của mô hình thường cần được đối chiếu với ngữ cảnh nghiệp vụ.
Có thể phát hiện dữ liệu bất thường khi không có dữ liệu đã gắn nhãn không?
Có. Các phương pháp như Isolation Forest, LOF, clustering và một số mô hình semi-supervised có thể hoạt động khi thiếu nhãn. Tuy nhiên, không có nhãn khiến việc xác định ngưỡng và đánh giá độ chính xác khó hơn.
Z-score có thể dùng cho mọi loại dữ liệu không?
Không. Z-score phù hợp hơn khi dữ liệu có phân bố tương đối ổn định và không lệch quá mạnh. Với dữ liệu nhiều ngoại lệ hoặc phân bố lệch, IQR hoặc các phương pháp robust thường thích hợp hơn.
Thuật toán phát hiện bất thường nào tốt nhất?
Không có thuật toán tốt nhất cho mọi trường hợp. Lựa chọn phụ thuộc vào số chiều dữ liệu, phân bố, yếu tố thời gian, lượng dữ liệu nhãn, loại bất thường và chi phí của false positive hoặc false negative.
Vì sao hệ thống phát hiện bất thường thường tạo nhiều cảnh báo sai?
Một nguyên nhân phổ biến là ngưỡng cảnh báo chưa phù hợp với phân bố thực tế hoặc trạng thái bình thường đã thay đổi. Ngoài ra, dữ liệu chưa được chuẩn hóa, biến đầu vào thiếu ngữ cảnh và mô hình không phản ánh mùa vụ cũng có thể làm tăng false positive.

GỬI Ý KIẾN BÌNH LUẬN

