
Cách kiểm tra tính nhất quán kết quả phân tích
Mục lục
Kiểm tra tính nhất quán kết quả phân tích cần bắt đầu từ việc cố định điều kiện chạy, xác định tiêu chí sai khác chấp nhận được, thực hiện nhiều lần chạy có kiểm soát và phân biệt sai khác do dữ liệu, môi trường, tính toán hay yếu tố ngẫu nhiên.
Một kết quả được xem là nhất quán không nhất thiết phải giống tuyệt đối ở mọi lần chạy. Mức độ giống nhau cần được đánh giá theo bản chất của quy trình phân tích. Với phép tính xác định, cùng đầu vào và cùng điều kiện thường phải tạo ra kết quả tương đương rất sát, thậm chí giống hoàn toàn ở những đầu ra rời rạc. Với quy trình có lấy mẫu, khởi tạo ngẫu nhiên hoặc thuật toán xác suất, từng lần chạy có thể khác nhau nhưng phân bố kết quả vẫn phải ổn định trong phạm vi đã xác định.
Vì vậy, kiểm tra tính nhất quán không chỉ là đặt hai kết quả cạnh nhau. Quy trình đúng cần kiểm soát điều kiện chạy, lượng hóa mức sai khác, xác định ngưỡng chấp nhận và truy nguyên nguyên nhân nếu sai khác vượt ngưỡng.
Xác định thế nào mới được xem là kết quả nhất quán
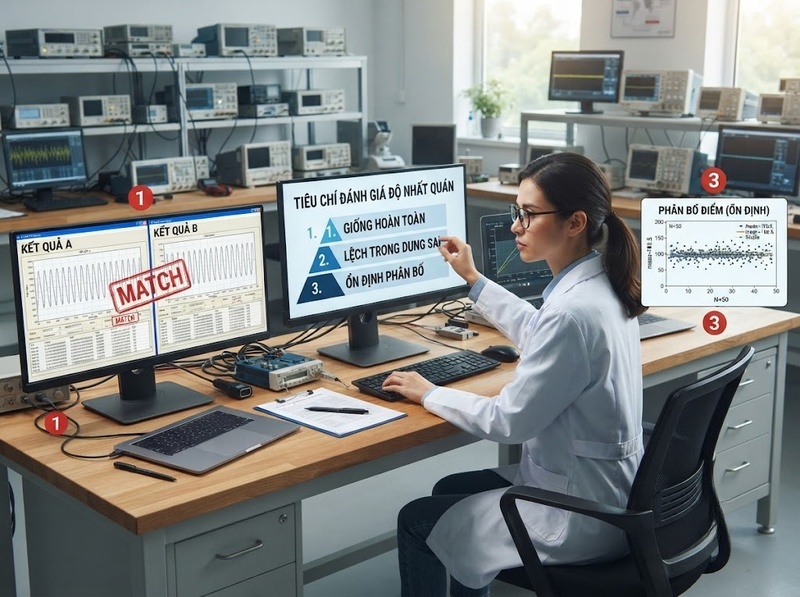
Bước đầu tiên là định nghĩa tiêu chí nhất quán trước khi xem kết quả. Nếu chỉ chạy phân tích nhiều lần rồi mới quyết định “khác bao nhiêu là chấp nhận được”, tiêu chí rất dễ bị điều chỉnh theo chính kết quả quan sát được.
Có ba trường hợp thường gặp.
Kết quả phải giống hoàn toàn
So sánh chính xác phù hợp khi toàn bộ quy trình có tính xác định và đầu ra không chịu ảnh hưởng đáng kể của sai số số học. Ví dụ, cùng một tập dữ liệu đi qua cùng một tập quy tắc phân loại thì nhãn đầu ra, số lượng bản ghi hoặc mã trạng thái có thể được yêu cầu giống nhau giữa các lần chạy.
Khi đó có thể kiểm tra:
· Số lượng bản ghi
· Giá trị đầu ra
· Thứ tự nếu thứ tự là một phần của kết quả
· Mã hoặc hash của tệp kết quả
· Các trường dữ liệu bắt buộc
Chỉ cần một thành phần khác biệt ngoài các trường đã được phép thay đổi là có thể xem lần chạy không nhất quán.
Kết quả được phép sai khác trong một dung sai
Với số thực, tính toán lặp nhiều bước hoặc xử lý trên các môi trường phần cứng khác nhau, yêu cầu bằng nhau tuyệt đối có thể quá nghiêm ngặt. Khi đó cần dùng dung sai.
Với một giá trị x, có thể tính sai khác tuyệt đối:
Δ=∣x1−x2∣
Sai khác tương đối có thể biểu diễn:
δ=max(∣xref∣,ε)∣x1−x2∣
Trong đó ε là một giá trị nhỏ dùng để tránh phép chia không ổn định khi giá trị tham chiếu gần 0.
Điểm quan trọng không nằm ở việc chọn một tỷ lệ cố định cho mọi bài toán. Ngưỡng chấp nhận phải xuất phát từ độ chính xác cần thiết, độ phân giải dữ liệu, sai số đo, yêu cầu nghiệp vụ hoặc tiêu chuẩn của chính phép phân tích.
Kết quả ngẫu nhiên nhưng phân bố phải ổn định
Nếu quá trình sử dụng random seed, bootstrap, Monte Carlo, sampling hoặc thuật toán có khởi tạo ngẫu nhiên, hai lần chạy khác nhau không tự động chứng minh hệ thống thiếu nhất quán.
Trong trường hợp này, đối tượng cần so sánh chuyển từ một kết quả đơn lẻ sang đặc điểm của tập kết quả qua nhiều lần chạy, chẳng hạn:
· Giá trị trung bình
· Độ lệch chuẩn
· Trung vị
· Các phân vị
· Khoảng biến thiên
· Tỷ lệ xuất hiện của từng loại kết quả
· Khoảng tin cậy khi phù hợp
Một quy trình có thể cho 10 kết quả khác nhau ở 10 lần chạy nhưng vẫn ổn định nếu mức biến thiên của chúng nằm trong phạm vi dự kiến. Ngược lại, hai lần chạy tình cờ gần nhau chưa đủ chứng minh tính nhất quán của một quá trình ngẫu nhiên.
Chuẩn hóa điều kiện trước khi chạy phép so sánh
Không thể kết luận kết quả thiếu nhất quán nếu hai lần phân tích thực chất được thực hiện dưới những điều kiện khác nhau.
Trước khi chạy lại, cần xác định những yếu tố nào phải được giữ nguyên. Tùy hệ thống, chúng có thể gồm dữ liệu đầu vào, phiên bản mã, tham số, thư viện, trình phân tích, cấu hình máy, seed ngẫu nhiên hoặc thứ tự xử lý dữ liệu.
Một hồ sơ chạy tối thiểu nên cho phép trả lời bốn câu hỏi:
1. Đã phân tích dữ liệu nào
2. Đã sử dụng logic và tham số nào
3. Phân tích chạy trong môi trường nào
4. Yếu tố ngẫu nhiên nào đã được cố định hoặc chủ động thay đổi
Ví dụ, nếu lần thứ nhất sử dụng một phiên bản dữ liệu và lần thứ hai sử dụng bản dữ liệu đã được cập nhật, chênh lệch kết quả không phải bằng chứng trực tiếp về sự thiếu ổn định của thuật toán. Đó trước hết là chênh lệch đầu vào.
Tương tự, nếu các phiên bản thư viện khác nhau, thay đổi trong cách triển khai một phép toán có thể truyền xuống kết quả cuối cùng. Vì vậy, việc lưu phiên bản môi trường cùng kết quả là một phần của kiểm tra tính nhất quán chứ không chỉ là công việc quản trị kỹ thuật.
Thực hiện nhiều lần chạy có kiểm soát
Một phép kiểm tra tốt nên tách hai câu hỏi khác nhau: quy trình có tái tạo được khi mọi điều kiện giống nhau hay không, và quy trình ổn định đến đâu khi những yếu tố được phép biến động thay đổi.
Kiểm tra với điều kiện cố định
Trước tiên, giữ nguyên:
· Dữ liệu
· Cấu hình
· Phiên bản mã
· Tham số
· Seed nếu có
· Môi trường thực thi trong phạm vi có thể kiểm soát
Sau đó chạy lại nhiều lần và so sánh đầu ra.
Nếu kết quả vẫn thay đổi đáng kể, cần tìm một nguồn không xác định đang tác động vào quá trình. Nguồn này có thể nằm ở xử lý song song, thứ tự dữ liệu, trạng thái bên ngoài, phép toán không xác định hoặc một thành phần chưa được ghi nhận trong cấu hình.
Kiểm tra khi chủ động thay đổi seed
Đối với phân tích ngẫu nhiên, cố định seed chỉ trả lời câu hỏi liệu một lần chạy cụ thể có thể được tái tạo hay không. Nó chưa cho biết kết quả có nhạy với ngẫu nhiên hay không.
Do đó nên có thêm một nhóm chạy với nhiều seed khác nhau. Sau đó đánh giá mức phân tán của chỉ số quan trọng.
Nếu một thay đổi rất nhỏ ở seed làm kết luận cuối cùng thường xuyên đảo chiều, vấn đề không còn đơn giản là “hai con số khác nhau”. Kết luận phân tích đang có độ nhạy cao với biến động ngẫu nhiên và cần được trình bày cùng mức bất định tương ứng.
Đo mức sai khác bằng chỉ số phù hợp với loại kết quả
Không có một chỉ số duy nhất phù hợp với mọi đầu ra. Phép đo cần phản ánh chính thứ mà người dùng xem là kết quả.
Với một giá trị số, sai khác tuyệt đối và tương đối thường đủ để kiểm tra trực tiếp. Với một chuỗi hoặc vector kết quả, có thể cần MAE hoặc RMSE để tổng hợp mức lệch trên nhiều phần tử.
Ví dụ, với n giá trị, MAE được tính:
MAE=n1i=1∑n∣xi−yi∣
RMSE nhấn mạnh mạnh hơn vào các sai khác lớn:
RMSE=n1i=1∑n(xi−yi)2
Nếu đầu ra là phân loại, chỉ nhìn vào giá trị trung bình không có ý nghĩa. Thay vào đó có thể kiểm tra tỷ lệ nhãn trùng khớp, số trường hợp đổi lớp hoặc ma trận thay đổi giữa hai lần chạy.
Nếu đầu ra là bảng dữ liệu, cần kiểm tra ở nhiều lớp: schema có giống nhau không, số hàng có thay đổi không, khóa định danh có còn đầy đủ không và giá trị trong các cột quan trọng sai khác bao nhiêu.
Một lỗi phổ biến là chỉ sử dụng hệ số tương quan. Hai chuỗi có thể tương quan rất cao nhưng vẫn có sai lệch hệ thống về mức hoặc thang đo. Vì vậy, tương quan chỉ phản ánh một dạng quan hệ, không tự nó chứng minh hai kết quả tương đương.
Phân biệt sai khác bình thường với dấu hiệu bất nhất
Khi phát hiện chênh lệch, câu hỏi cần trả lời không phải chỉ là “có khác hay không” mà là “khác vì điều gì”.
Có thể truy nguyên theo thứ tự từ đầu vào đến đầu ra.
Dữ liệu đầu vào là điểm kiểm tra đầu tiên. Cần xác nhận cùng phiên bản dữ liệu, cùng phạm vi bản ghi và cùng quy tắc tiền xử lý.
Tham số và cấu hình là lớp tiếp theo. Một giá trị mặc định thay đổi hoặc một tham số không được lưu lại có thể khiến hai lần chạy tưởng như giống nhau thực chất khác cấu hình.
Tính ngẫu nhiên cần được kiểm tra bằng seed và bằng các lần chạy với seed khác nhau. Nếu cố định seed làm kết quả ổn định trở lại, nguồn biến động đã được khoanh vùng đáng kể.
Môi trường tính toán cần được xem xét khi cùng mã và dữ liệu vẫn tạo sai khác. Phiên bản thư viện, trình biên dịch, phần cứng hoặc cách thực hiện tính toán song song có thể tạo chênh lệch, đặc biệt trong chuỗi tính toán số thực dài.
Trạng thái bên ngoài cũng có thể ảnh hưởng. Một quy trình đọc dữ liệu từ API, cơ sở dữ liệu đang thay đổi hoặc tài nguyên dùng chung không thể được coi là có đầu vào cố định chỉ vì tệp mã không thay đổi.
Cách truy nguyên hiệu quả là so sánh các đầu ra trung gian thay vì chỉ nhìn kết quả cuối. Nếu bước 1 giống nhau, bước 2 giống nhau nhưng bước 3 bắt đầu lệch, phạm vi điều tra được thu hẹp xuống thành phần nằm giữa bước 2 và bước 3.
Thiết lập tiêu chí PASS/FAIL cho các lần chạy sau
Kiểm tra tính nhất quán có giá trị nhất khi nó trở thành một kiểm soát lặp lại được thay vì một lần đối chiếu thủ công.
Mỗi chỉ số quan trọng nên có ba thành phần: giá trị tham chiếu, cách đo sai khác và điều kiện chấp nhận. Ví dụ, một quy trình có thể quy định số bản ghi phải trùng tuyệt đối, tổng tiền được phép lệch không quá một dung sai số học đã xác định và một chỉ số ngẫu nhiên phải nằm trong khoảng biến thiên đã được xác lập từ các lần chạy kiểm chứng.
Không nên sử dụng một ngưỡng tùy ý như “sai khác dưới 5% luôn là ổn”. Mức 5% có thể không đáng kể đối với một chỉ số mang tính thăm dò nhưng không thể chấp nhận với một phép đối soát cần chính xác đến từng đơn vị. Ngưỡng phải gắn với ý nghĩa của chỉ số.
Một cơ chế kiểm tra thực tế có thể gồm:
1. Lưu một kết quả tham chiếu đã được xác nhận
2. Ghi lại dữ liệu, phiên bản mã, cấu hình và môi trường của từng lần chạy
3. Chạy lại theo cùng điều kiện
4. So sánh từng chỉ số bằng phép đo đã định nghĩa
5. Đánh dấu PASS khi toàn bộ tiêu chí bắt buộc nằm trong ngưỡng
6. Nếu FAIL, tìm bước đầu tiên xuất hiện sai khác
7. Chỉ cập nhật kết quả tham chiếu khi có một thay đổi có chủ đích và đã được xác minh
Cách làm này đặc biệt quan trọng khi quy trình phân tích được sửa đổi thường xuyên. Một kết quả mới khác kết quả cũ có thể là cải tiến hợp lệ, nhưng cũng có thể là regression. Chỉ khi biết chính xác dữ liệu, mã và tiêu chí chấp nhận đã thay đổi ở đâu mới phân biệt được hai trường hợp.
Để kiểm tra tính nhất quán kết quả phân tích, cần bắt đầu từ một định nghĩa đo được về “nhất quán”, sau đó cố định các điều kiện phải giống nhau, chạy lặp có kiểm soát và lượng hóa chênh lệch bằng chỉ số phù hợp với loại đầu ra. Với quá trình xác định, có thể yêu cầu kết quả giống hoàn toàn hoặc nằm trong dung sai số học. Với quá trình ngẫu nhiên, cần đánh giá độ ổn định của phân bố qua nhiều lần chạy thay vì đòi hỏi từng kết quả đơn lẻ phải trùng nhau.
Nếu sai khác vượt ngưỡng, việc so sánh đầu ra trung gian cùng hồ sơ dữ liệu, cấu hình, seed và môi trường sẽ giúp xác định điểm đầu tiên tạo ra độ lệch. Khi các tiêu chí này được chuẩn hóa thành điều kiện PASS/FAIL, kiểm tra tính nhất quán trở thành một cơ chế kiểm soát có thể tái sử dụng cho mọi lần phân tích tiếp theo.

GỬI Ý KIẾN BÌNH LUẬN

