
Cách xử lý dữ liệu thiếu khi thu thập
Mục lục
- Phát hiện dữ liệu thiếu ngay tại điểm phát sinh
- Phân loại giá trị thiếu trước khi quyết định xử lý
- Xử lý dữ liệu thiếu theo khả năng phục hồi
- Thiết lập quality gate để dữ liệu thiếu không lan xuống hệ thống sau
- Lưu nguyên nhân thiếu và bảo toàn dữ liệu gốc
- Những cách xử lý tưởng nhanh nhưng dễ làm sai dữ liệu
Dữ liệu thiếu nên được phát hiện ngay tại điểm thu thập, phân loại theo nguyên nhân và xử lý theo khả năng phục hồi. Cách làm này giúp ngăn giá trị thiếu bất thường lan xuống các bước xử lý sau mà không biến dữ liệu chưa biết thành dữ liệu giả.
Xử lý dữ liệu thiếu hiệu quả không bắt đầu bằng việc tìm một giá trị để điền vào ô trống. Trong giai đoạn thu thập, mục tiêu quan trọng hơn là làm cho trạng thái thiếu trở nên có thể phát hiện, có thể giải thích và có thể phục hồi khi còn cơ hội lấy lại dữ liệu.
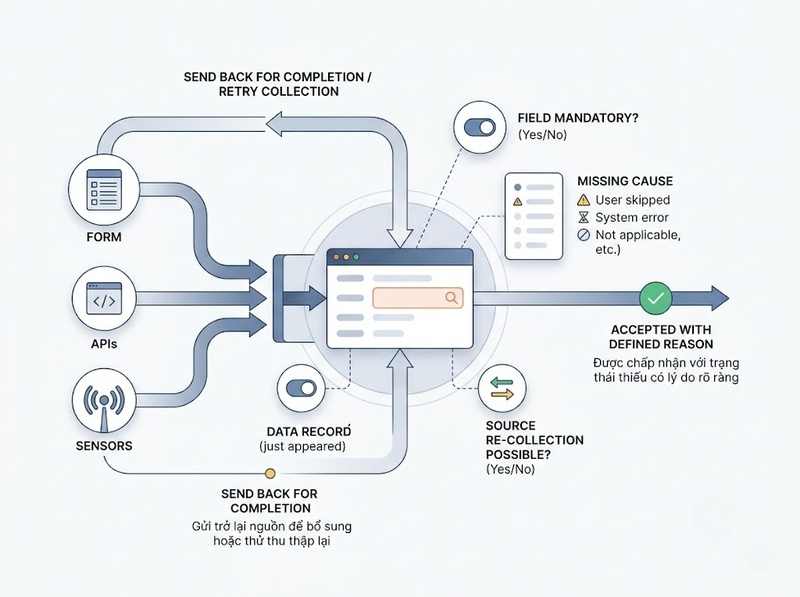
Vì vậy, một giá trị không xuất hiện cần được trả lời ba câu hỏi ngay khi phát sinh: trường đó có thực sự phải có dữ liệu không, nguyên nhân thiếu là gì và nguồn dữ liệu còn có thể được yêu cầu cung cấp lại hay không. Chỉ sau ba bước này mới nên quyết định chặn bản ghi, thử lại, thu thập lại hoặc chấp nhận trạng thái thiếu có kiểm soát.
Phát hiện dữ liệu thiếu ngay tại điểm phát sinh
Dữ liệu thiếu càng được phát hiện muộn thì khả năng khắc phục thường càng thấp. Khi người dùng vẫn đang điền biểu mẫu, thiết bị vẫn đang hoạt động hoặc kết nối tới nguồn dữ liệu vẫn còn hiệu lực, hệ thống còn cơ hội yêu cầu bổ sung hoặc thực hiện lại việc thu thập.
Bởi vậy, kiểm tra completeness nên nằm trong chính luồng thu thập thay vì chỉ chạy sau khi dữ liệu đã được nhập kho.
Kiểm tra theo quy tắc của từng trường dữ liệu
Nguồn có thẩm quyền đầu tiên để xác định một giá trị có “thiếu” hay không là data contract, schema và quy tắc nghiệp vụ của quy trình thu thập. Không phải trường trống nào cũng là lỗi.
Một trường có thể thuộc một trong ba nhóm:
· Bắt buộc đối với mọi bản ghi
· Bắt buộc khi một điều kiện cụ thể được thỏa mãn
· Không bắt buộc hoặc không áp dụng với một số bản ghi
Ví dụ, trường “ngày kết thúc hợp đồng” không thể bị coi là thiếu đối với hợp đồng vẫn còn hiệu lực. Ngược lại, nếu mã định danh là điều kiện bắt buộc để liên kết bản ghi với đối tượng khảo sát, việc thiếu mã này có thể khiến toàn bộ bản ghi không sử dụng được.
Vì vậy, validation phải kiểm tra cả sự tồn tại lẫn điều kiện bắt buộc. Chỉ kiểm tra NULL hoặc chuỗi rỗng là chưa đủ.
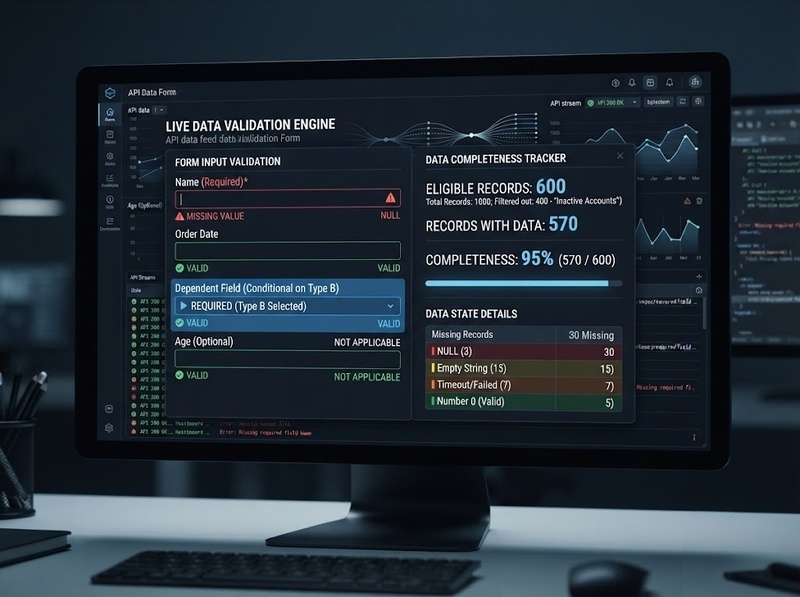
Trong các nguồn kỹ thuật, hệ thống cũng cần phân biệt giữa không có key, giá trị null, chuỗi rỗng, timeout và giá trị số 0. Chúng có thể mang những ý nghĩa hoàn toàn khác nhau.
Đo completeness bằng đúng mẫu số
Một chỉ số đơn giản có thể dùng ngay trong quá trình thu thập là:
Completeness = Số bản ghi có giá trị hợp lệ / Số bản ghi phải có giá trị × 100%
Điểm quan trọng nằm ở mẫu số. Chỉ những bản ghi đủ điều kiện phải có trường đó mới được tính.
Nếu một trường chỉ áp dụng cho 600 trong 1.000 bản ghi và 570 bản ghi có giá trị, completeness của trường là 570/600 = 95%, không phải 570/1.000 = 57%.
Việc dùng sai mẫu số có thể khiến một trường hoàn toàn hợp lệ bị báo là thiếu nghiêm trọng hoặc ngược lại che khuất lỗi ở một nhóm bản ghi cụ thể.
Phân loại giá trị thiếu trước khi quyết định xử lý
Một lỗi phổ biến là gom tất cả dữ liệu thiếu vào cùng một trạng thái NULL. Khi đó hệ thống biết rằng “không có giá trị”, nhưng không còn biết tại sao không có. Chính thông tin về nguyên nhân mới quyết định cách xử lý thích hợp.
Có thể phân loại dữ liệu thiếu trong quá trình thu thập thành một số trạng thái thực dụng.
Không áp dụng là trường hợp dữ liệu không được kỳ vọng xuất hiện. Đây không phải lỗi và không nên kích hoạt việc thu thập lại.
Chưa có dữ liệu là trạng thái tạm thời. Nguồn có thể cung cấp thông tin sau, chẳng hạn một API phụ thuộc chưa phản hồi hoặc kết quả đo chưa hoàn thành.
Thu thập thất bại xảy ra khi dữ liệu đáng lẽ phải có nhưng bị mất do lỗi kỹ thuật, timeout, thiết bị, nhập liệu hoặc truyền dữ liệu. Đây là nhóm nên ưu tiên phục hồi.
Không thể thu thập là trường hợp đã biết nguyên nhân nhưng không còn khả năng lấy được giá trị, chẳng hạn người tham gia từ chối trả lời hoặc nguồn gốc không cung cấp trường cần thiết.
Không rõ nguyên nhân là trạng thái cần được xem như tín hiệu chất lượng dữ liệu. Nếu tỷ lệ này tăng, hệ thống đang thiếu khả năng quan sát chính quá trình thu thập.
Phân loại như vậy giúp tránh một sai lầm quan trọng: coi “không áp dụng”, “từ chối cung cấp” và “hệ thống bị lỗi” là ba biểu hiện của cùng một vấn đề.
Xử lý dữ liệu thiếu theo khả năng phục hồi
Sau khi xác định trường dữ liệu thực sự bị thiếu, tiêu chí thực dụng nhất để lựa chọn hành động là: còn lấy lại được dữ liệu gốc hay không?
Khi có thể phục hồi ngay
Nếu người cung cấp dữ liệu hoặc nguồn dữ liệu vẫn còn trong phiên thu thập, nên sửa vấn đề tại nguồn.
Với biểu mẫu nhập liệu, hệ thống có thể yêu cầu người dùng hoàn thành trường bắt buộc, cảnh báo quan hệ bất hợp lý giữa các trường hoặc xác nhận lý do bỏ trống. Tuy nhiên, validation không nên biến mọi trường thành bắt buộc chỉ để đạt completeness cao; điều đó dễ tạo ra dữ liệu giả khi người nhập buộc phải chọn một giá trị không đúng.
Với API, cảm biến hoặc pipeline tự động, dữ liệu thiếu do lỗi tạm thời có thể được xử lý bằng retry có giới hạn. Nếu thao tác có khả năng được gửi lại nhiều lần, luồng thu thập cần bảo đảm việc retry không vô tình tạo bản ghi trùng hoặc ghi đè sai dữ liệu đã nhận.
Một lần thu thập lại giá trị thật thường có giá trị hơn nhiều so với việc cố suy đoán nó sau khi quá trình thu thập đã kết thúc.
Khi có thể phục hồi sau
Không phải dữ liệu nào cũng lấy lại được ngay lập tức. Trong trường hợp nguồn chỉ tạm thời không khả dụng, bản ghi có thể được đưa vào hàng đợi để thử lại, đánh dấu trạng thái “pending” hoặc chuyển sang bước rà soát thủ công.
Điều quan trọng là không biến trạng thái “chưa lấy được” thành “không tồn tại”.
Hai trạng thái này tạo ra quyết định vận hành khác nhau: dữ liệu pending còn cần hành động, còn dữ liệu không áp dụng thì không.
Khi không thể phục hồi
Nếu giá trị gốc không còn khả năng thu thập, hệ thống nên lưu trạng thái thiếu cùng nguyên nhân thay vì tự động tạo một giá trị thay thế.
Không nên điền 0, giá trị trung bình, giá trị phổ biến nhất hay một giá trị mặc định chỉ để làm trường dữ liệu trông đầy đủ hơn. Số 0 chỉ hợp lệ nếu nguồn thực sự xác nhận giá trị bằng 0; nếu chưa biết giá trị thì 0 là một thông tin khác hoàn toàn.
Các phương pháp ước lượng hoặc imputation, nếu thực sự cần, thuộc giai đoạn xử lý và phân tích sau đó và phải được thực hiện theo phương pháp rõ ràng. Chúng không nên âm thầm thay thế dữ liệu gốc ngay tại điểm thu thập.
Thiết lập quality gate để dữ liệu thiếu không lan xuống hệ thống sau
Phát hiện một trường bị thiếu mới chỉ xử lý từng bản ghi. Một hệ thống thu thập tốt còn cần phát hiện mẫu hình thiếu dữ liệu.
Ví dụ, completeness chung của một trường có thể vẫn ở mức cao nhưng gần như toàn bộ giá trị thiếu lại đến từ một thiết bị, một chi nhánh, một phiên bản ứng dụng hoặc một khoảng thời gian cụ thể. Nếu chỉ nhìn tỷ lệ tổng, lỗi hệ thống này có thể bị che khuất.
Vì vậy nên theo dõi completeness ít nhất theo các chiều có khả năng phản ánh nguồn phát sinh lỗi, chẳng hạn nguồn dữ liệu, thiết bị, người nhập, phiên bản phần mềm hoặc thời gian.
Quality gate có thể hoạt động theo mức độ quan trọng của từng trường.
Với trường bắt buộc tuyệt đối để bản ghi có ý nghĩa, quy tắc nghiệp vụ có thể yêu cầu completeness 100% và từ chối bản ghi không đạt. Với trường không bắt buộc, việc đặt ngưỡng 100% lại không có ý nghĩa.
Không có một tỷ lệ như 5% hay 10% dữ liệu thiếu có thể áp dụng máy móc cho mọi tập dữ liệu. Ngưỡng phải phụ thuộc vào:
· Mức độ quan trọng của trường
· Khả năng thu thập lại
· Mục đích sử dụng dữ liệu
· Mức completeness thông thường của chính nguồn đó
· Hậu quả nếu dữ liệu thiếu được chuyển xuống bước tiếp theo
Ngoài ngưỡng tuyệt đối, biến động theo thời gian cũng rất hữu ích. Một nguồn thường đạt completeness 99% nhưng đột ngột giảm xuống 93% có thể đáng điều tra hơn một trường tùy chọn luôn ổn định quanh 90%.
Quality gate vì thế không chỉ trả lời “thiếu bao nhiêu”, mà còn phải cho biết thiếu ở đâu, bắt đầu từ khi nào và tập trung ở nguồn nào.
Lưu nguyên nhân thiếu và bảo toàn dữ liệu gốc
Một bản ghi thiếu dữ liệu vẫn có thể có giá trị nếu trạng thái thiếu được mô tả đầy đủ.
Thay vì chỉ lưu một trường trống, pipeline có thể giữ thêm metadata như mã nguyên nhân, thời điểm thu thập, nguồn, số lần thử, kết quả validation và trạng thái phục hồi.
Chẳng hạn, các reason code có thể phân biệt:
NOT_APPLICABLE — trường không áp dụng
REFUSED — đối tượng từ chối cung cấp
SOURCE_UNAVAILABLE — nguồn không khả dụng
TIMEOUT — hết thời gian chờ
VALIDATION_FAILED — giá trị nhận được nhưng không đạt quy tắc
UNKNOWN — chưa xác định được nguyên nhân
Tên mã cụ thể tùy hệ thống; giá trị nằm ở việc duy trì ý nghĩa nhất quán.
Một nguyên tắc quan trọng khác là không phá hủy dữ liệu gốc trong quá trình sửa lỗi. Nếu hệ thống nhận được một giá trị nhưng validation không chấp nhận, nên giữ raw value ở lớp phù hợp và ghi rõ kết quả kiểm tra thay vì xóa sạch dấu vết.
Cách này tạo khả năng truy vết: sau này có thể xác định dữ liệu thiếu xuất hiện từ nguồn, từ quá trình truyền, từ quy tắc validation hay từ một bước chuyển đổi.
Nó cũng giúp phân biệt hai vấn đề rất khác nhau: “nguồn không cung cấp dữ liệu” và “hệ thống đã nhận dữ liệu nhưng loại bỏ nó”.
Những cách xử lý tưởng nhanh nhưng dễ làm sai dữ liệu
Tự động điền giá trị mặc định có thể làm completeness trông đẹp hơn nhưng làm mất ranh giới giữa dữ liệu quan sát được và dữ liệu do hệ thống tạo ra. Nếu 0 thực chất có nghĩa “không biết”, các phép tính sau đó sẽ coi những giá trị chưa biết là số 0 thật.
Xóa toàn bộ bản ghi có trường thiếu cũng có thể gây mất thông tin không cần thiết. Một trường tùy chọn bị thiếu không đồng nghĩa với toàn bộ bản ghi vô giá trị. Quyết định loại bỏ phải dựa trên trường nào thiếu và mục đích sử dụng bản ghi.
Chỉ kiểm tra dữ liệu sau khi kết thúc thu thập làm mất cơ hội phục hồi. Khi người nhập đã rời phiên, thiết bị đã chuyển sang chu kỳ khác hoặc API nguồn không còn lưu trạng thái cũ, việc lấy lại giá trị thật có thể khó hơn nhiều.
Chỉ nhìn tỷ lệ thiếu toàn cục có thể bỏ qua lỗi có hệ thống. Nếu dữ liệu thiếu tập trung ở một nhóm, một thiết bị hoặc một giai đoạn, vấn đề không còn là vài ô trống ngẫu nhiên mà có thể là lỗi của chính quy trình thu thập.
Gộp mọi nguyên nhân vào một giá trị NULL làm mất thông tin cần thiết để quyết định hành động. Một trường không áp dụng không cần sửa; một trường timeout cần retry; một trường bị từ chối cần được giữ nguyên trạng thái. Cùng là “không có giá trị”, nhưng cơ chế xử lý hoàn toàn khác nhau.
Cách an toàn hơn là coi dữ liệu thiếu như một trạng thái cần quản trị, không phải một ô trống cần được lấp đầy bằng mọi giá.
Xử lý dữ liệu thiếu khi thu thập hiệu quả cần diễn ra trước khi dữ liệu rời khỏi nguồn càng nhiều càng tốt. Hệ thống nên xác định trường nào thực sự bắt buộc, phát hiện thiếu ngay tại điểm phát sinh, ghi nhận nguyên nhân rồi ưu tiên lấy lại dữ liệu thật nếu còn khả năng phục hồi.
Nếu không thể thu lại, nên giữ trạng thái thiếu một cách minh bạch thay vì tự tạo giá trị thay thế. Khi kết hợp validation tại nguồn, completeness theo đúng đối tượng đủ điều kiện, quality gate theo nguồn và thời gian, cùng metadata về nguyên nhân, dữ liệu thiếu trở thành một vấn đề có thể quan sát và kiểm soát thay vì chỉ được phát hiện khi đã quá muộn.

GỬI Ý KIẾN BÌNH LUẬN

