
Cách bảo đảm tính toàn vẹn dữ liệu nghiên cứu
Mục lục
- Tính toàn vẹn trong lưu trữ phải được kiểm chứng, không chỉ được giả định
- Tạo và kiểm tra checksum để phát hiện dữ liệu bị thay đổi
- Hạn chế sửa, xóa bằng phân quyền, versioning và lưu trữ bất biến
- Tách biệt bản sao lưu và kiểm thử khả năng khôi phục
- Dùng audit trail để truy vết và xử lý sai lệch toàn vẹn
- Xây dựng chu kỳ kiểm tra toàn vẹn theo mức độ rủi ro
Bài viết giải thích cách duy trì tính toàn vẹn dữ liệu nghiên cứu trong lưu trữ bằng kiểm tra fixity/checksum, phân quyền, versioning và lưu trữ bất biến, bản sao tách biệt, audit trail và kiểm thử khôi phục; đồng thời làm rõ giới hạn của từng biện pháp và cách đặt lịch kiểm tra theo mức độ rủi ro.
Trong lưu trữ, “dữ liệu còn tồn tại” chưa đồng nghĩa “dữ liệu còn toàn vẹn”. Một tệp vẫn có thể mở được nhưng đã bị sửa ngoài quy trình, hư hỏng một phần, bị ghi đè bằng phiên bản sai hoặc mất dấu vết về ai đã thay đổi nó. Vì vậy, tính toàn vẹn dữ liệu nghiên cứu cần được nhìn như khả năng chứng minh rằng trạng thái dữ liệu hiện tại phù hợp với một trạng thái chuẩn đã được chấp nhận, và mọi sai lệch đều có thể được phát hiện, truy vết hoặc phục hồi. Khái niệm fixity của NDSA tập trung đúng vào khả năng xác minh một đối tượng số không bị thay đổi theo cách không được ghi nhận.
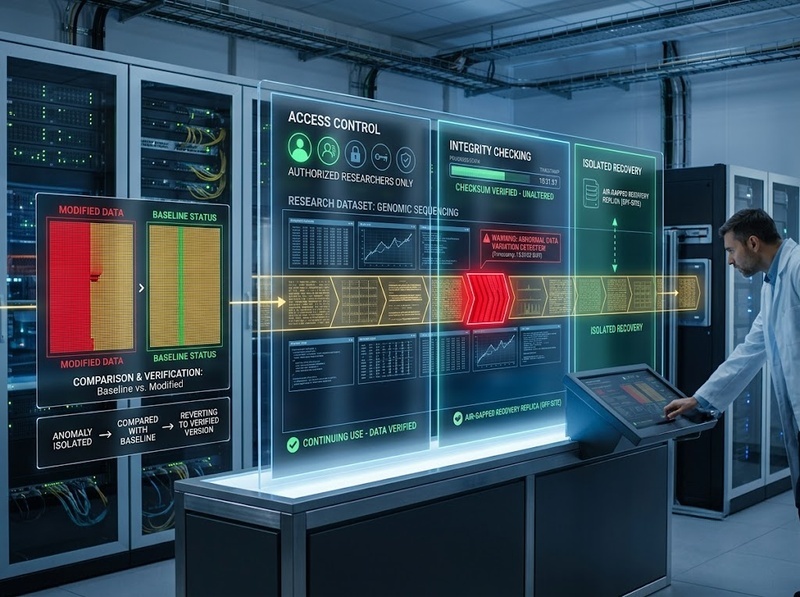
Cách tiếp cận hiệu quả là phối hợp ba lớp kiểm soát: phòng ngừa thay đổi trái phép, phát hiện thay đổi ngoài dự kiến và phục hồi từ bản sao đã được xác minh. Không lớp nào thay thế hoàn toàn lớp khác: checksum không ngăn sửa dữ liệu, backup không chứng minh bản sao còn dùng được, còn phân quyền không cho biết dữ liệu có bị bit rot hay hư hỏng âm thầm hay không. Đây là cách tổng hợp từ các nhóm kiểm soát về integrity, access control, audit và recovery trong hướng dẫn NIST về hệ thống và hạ tầng lưu trữ.
Tính toàn vẹn trong lưu trữ phải được kiểm chứng, không chỉ được giả định
Trong bảo quản số, NDSA định nghĩa “fixity check” là cơ chế xác minh một đối tượng số không bị thay đổi theo cách không được ghi nhận; checksum, message digest và chữ ký số là những công cụ có thể dùng cho mục đích này. Cách hiểu này rất phù hợp với dữ liệu nghiên cứu: điều cần bảo vệ không chỉ là sự tồn tại của tệp, mà là khả năng kiểm chứng rằng bitstream hiện tại vẫn tương ứng với trạng thái đã được chấp nhận.
Từ đó, một hệ thống lưu trữ có tính toàn vẹn không thể chỉ dựa vào một cơ chế. Nó cần đồng thời trả lời ba câu hỏi. Thứ nhất, ai có quyền sửa hoặc xóa dữ liệu và quyền đó được giới hạn ra sao? Thứ hai, làm thế nào phát hiện dữ liệu đã thay đổi dù thay đổi đó không tạo lỗi rõ ràng? Thứ ba, nếu dữ liệu hoặc hệ thống lưu trữ bị hỏng, có thể phục hồi một bản sao đã được xác minh hay không? NIST SP 800-53 cũng tách các nhóm kiểm soát liên quan thành những họ như Access Control, Audit and Accountability, Contingency Planning và System and Information Integrity. Từ cấu trúc này có thể suy ra rằng bảo vệ integrity trong một hệ thống thực tế cần nhiều lớp kiểm soát phối hợp, thay vì chỉ một tính năng đơn lẻ.
Điểm dễ nhầm là mã hóa, sao lưu và tính toàn vẹn có mục tiêu giao nhau nhưng không đồng nhất. NIST mô tả mã hóa at-rest như biện pháp bảo vệ dữ liệu nhạy cảm trước truy cập trái phép và các rủi ro như mất hoặc bị lấy cắp media, trong khi phần Restoration Assurance của cùng tài liệu xử lý riêng bài toán phục hồi. Fixity lại trả lời câu hỏi dữ liệu có thay đổi so với trạng thái chuẩn hay không. Vì vậy, ba nhóm này nên bổ trợ nhau: bản sao có thể được tạo từ dữ liệu đã hỏng, dữ liệu mã hóa vẫn có thể bị xóa hoặc ghi đè bởi chủ thể có quyền phù hợp, còn checksum đúng không tạo ra bản sao để phục hồi khi tệp mất hoàn toàn.
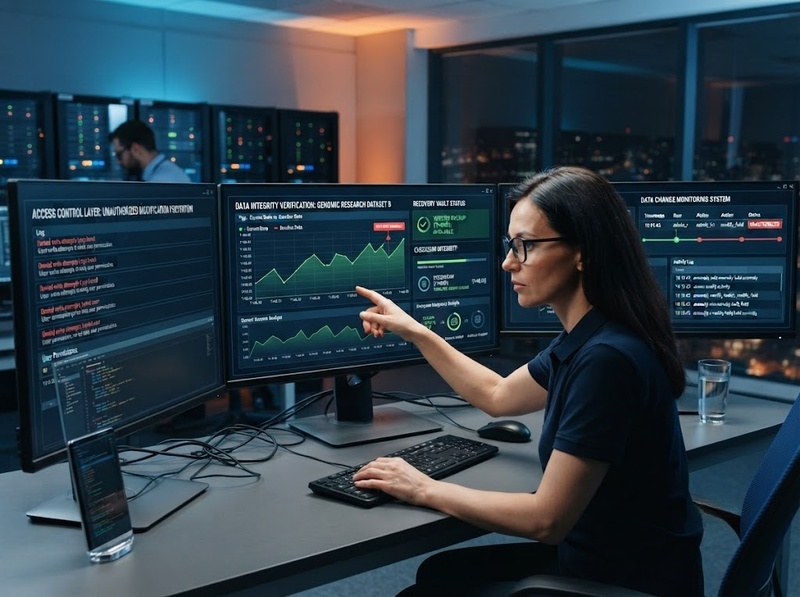
Tạo và kiểm tra checksum để phát hiện dữ liệu bị thay đổi
Checksum hoặc hàm băm mật mã biến nội dung của tệp thành một giá trị đại diện. Khi dữ liệu được chốt để lưu trữ, hệ thống tính giá trị này làm baseline. Ở lần kiểm tra sau, hệ thống tính lại trên chính bitstream đang được lưu và so sánh với baseline. Nếu hai giá trị không khớp, phải coi đó là tín hiệu rằng nội dung byte-level đã thay đổi cho đến khi xác định được nguyên nhân. Library of Congress mô tả fixity như nền tảng của bảo quản số và lưu ý rằng phần mềm fixity có thể quét theo lịch để phát hiện tệp hoặc checksum đã thay đổi.
Thiết lập checksum chuẩn khi dữ liệu được chốt
Baseline nên được tạo ở một thời điểm có ý nghĩa nghiệp vụ: khi dữ liệu gốc được nhập kho lưu trữ, khi một phiên bản phân tích được “đóng băng”, hoặc sau một lần chuyển đổi/migration đã được xác nhận thành công. Giá trị checksum phải được gắn với đúng định danh tệp hoặc đối tượng dữ liệu, đúng phiên bản và thời điểm tạo. Nếu baseline không được kiểm soát, người có quyền sửa dữ liệu có thể thay cả tệp lẫn checksum tham chiếu, khiến phép kiểm tra mất giá trị chứng minh. Đây là cách triển khai phù hợp với nguyên tắc fixity phải được thiết lập và theo dõi xuyên suốt quá trình bảo quản.
Một thiết kế thực dụng là lưu fixity information như metadata bảo quản, bảo vệ metadata đó bằng quyền truy cập chặt hơn hoặc ít nhất tách quyền sửa baseline khỏi quyền sửa dữ liệu nghiên cứu. Với tập dữ liệu lớn gồm nhiều tệp, manifest checksum giúp kiểm tra theo lô và phát hiện chính xác đối tượng nào lệch. NDSA nhấn mạnh rằng fixity information là bằng chứng hỗ trợ tính toàn vẹn và tính xác thực của đối tượng số.
Kiểm tra lại checksum theo lịch và theo sự kiện
Checksum chỉ có giá trị khi được tính lại. Ngoài kiểm tra định kỳ, nên kích hoạt kiểm tra sau các sự kiện làm tăng nguy cơ sai lệch, chẳng hạn chuyển dữ liệu sang hệ thống lưu trữ mới, khôi phục từ backup, thay đổi hạ tầng lưu trữ hoặc phát hiện lỗi media. Library of Congress mô tả việc so sánh giá trị fixity lịch sử với phép tính mới để nhận biết thay đổi, kể cả khi nội dung được di chuyển giữa hệ thống hoặc media. Sau mỗi lần kiểm tra thành công, hệ thống không nhất thiết phải thay baseline; baseline chỉ nên thay khi có một thay đổi dữ liệu hợp lệ đã được phê duyệt và phiên bản mới được xác nhận.
Cũng cần hiểu giới hạn của cơ chế này. Checksum xác nhận fixity ở mức bit so với một baseline; từ định nghĩa fixity của NDSA có thể suy ra rằng phép kiểm tra này không tự chứng minh dữ liệu đúng về mặt khoa học, đủ biến số hay không, hoặc quá trình thu thập ban đầu có sai sót hay không. Nó cũng không ngăn người có quyền ghi sửa tệp. Vì vậy, fixity phải đi cùng kiểm soát truy cập, versioning, log và bản sao phục hồi.
Hạn chế sửa, xóa bằng phân quyền, versioning và lưu trữ bất biến
Lớp phòng ngừa tập trung vào quyền có thể làm thay đổi trạng thái lưu trữ: write, overwrite, delete, đổi ACL, thay retention, dừng backup hoặc xóa version. NIST SP 800-209 khuyến nghị mô hình least privilege và tách nhiệm vụ; tài liệu nêu rõ quyền quản trị dữ liệu và quyền cấu hình, dừng hoặc xóa backup nên được giao cho các vai trò khác nhau, đồng thời mỗi vai trò chỉ có các quyền tối thiểu cần thiết.
Đối với dữ liệu nghiên cứu, điều đó có nghĩa tài khoản dùng để phân tích không nên mặc nhiên có quyền xóa kho lưu trữ gốc, còn người quản trị hạ tầng không nhất thiết phải có quyền thay đổi dữ liệu nội dung. Quyền “read”, “write”, “delete” và quyền quản trị chính sách bảo vệ nên được tách càng rõ càng tốt. Theo cơ chế separation of duties mà NIST nêu, cách thiết kế này làm giảm khả năng một tài khoản đơn lẻ có thể đồng thời phá dữ liệu chính và vô hiệu hóa cơ chế khôi phục.
Versioning bổ sung một lớp khác. Thay vì ghi đè trạng thái cũ, hệ thống giữ nhiều phiên bản để có thể quay lại một điểm trước thay đổi. NIST SP 800-209 cũng xem versioning và point-in-time copies là các cơ chế hữu ích trong bảo vệ dữ liệu liên tục và điều tra sự cố. Tuy nhiên, versioning chỉ có ý nghĩa nếu các version cũ không thể bị xóa dễ dàng bởi cùng tài khoản đã sửa dữ liệu.
Với dữ liệu cần mức bảo vệ cao hơn, immutable storage, WORM hoặc object locking có thể dùng để ngăn sửa/xóa trong khoảng retention đã định. NIST SP 800-209 khuyến nghị cân nhắc immutable storage để tăng mức cô lập và bảo vệ dữ liệu phục hồi. Giới hạn quan trọng là tính bất biến không “chữa” dữ liệu đã hỏng trước khi khóa. Nếu phiên bản sai được đưa vào vùng immutable, hệ thống chỉ bảo quản sai lệch đó lâu hơn. Do vậy, cần xác minh fixity trước hoặc ngay sau khi tạo bản bất biến.
Tách biệt bản sao lưu và kiểm thử khả năng khôi phục
Backup là điều kiện cần cho phục hồi nhưng không tự động bảo đảm tính toàn vẹn. NIST chỉ ra rằng backup, replica và snapshot đều có thể bị ảnh hưởng bởi cấu hình sai, thay đổi môi trường hoặc tấn công; nếu bản sao phụ thuộc quá chặt vào production, cùng một sự cố có thể làm hỏng cả dữ liệu chính lẫn đường phục hồi. Vì thế, tài liệu khuyến nghị duy trì đủ mức cô lập giữa các loại recovery copy và production baseline.
Bản sao phải tách khỏi miền lỗi của dữ liệu chính
“Tách biệt” không nhất thiết chỉ là đặt dữ liệu ở một địa điểm khác. Mục tiêu là giảm các phụ thuộc có thể khiến một lỗi lan sang mọi bản sao. Tùy mức rủi ro, sự tách biệt có thể bao gồm tài khoản quản trị khác, miền quyền khác, retention độc lập, immutable copy, media/off-site copy hoặc vùng lưu trữ không được mount thường trực vào production. NIST SP 800-209 nêu cả independent baseline copy, isolation giữa các loại bản sao và khả năng dùng air gap hoặc các cơ chế cô lập tương đương cho recovery copy nhạy cảm.
Replication cần được nhìn đúng vai trò. NIST xem replication, snapshots và backup là các dạng data copy có thể cùng bị ảnh hưởng khi quyền cao bị lạm dụng hoặc khi recovery copies không được cô lập đủ. Từ cơ chế đó có thể suy ra rằng replica đồng bộ không nên là bản sao phục hồi duy nhất, vì trạng thái sai có thể lan sang bản sao; cần ít nhất một lớp có lịch sử phiên bản, retention hoặc mức cô lập đủ để quay lại trạng thái trước sự cố.
Restore test mới xác nhận bản sao thực sự dùng được
Một backup “hoàn tất” chỉ chứng minh quá trình tạo bản sao đã chạy đến cuối; nó chưa chứng minh dữ liệu có thể khôi phục trung thực, đầy đủ và trong thời gian chấp nhận được. NIST SP 800-209 dành riêng phần Restoration Assurance để yêu cầu xác minh rằng các thành phần dữ liệu quan trọng có thể được phục hồi trung thực, nhất quán và đầy đủ; tài liệu cũng yêu cầu test restore định kỳ và kiểm tra sức khỏe của remote replicas, backup và data copies.
Trong nghiên cứu, có thể triển khai Restoration Assurance của NIST theo cách cụ thể hơn: không chỉ “mở được tệp” mà còn so checksum của dữ liệu sau phục hồi với giá trị chuẩn thích hợp, kiểm tra cấu trúc thư mục/đối tượng, metadata cần thiết và khả năng đọc bằng công cụ dự kiến. Đây là phép áp dụng vào bối cảnh dữ liệu nghiên cứu của yêu cầu khôi phục trung thực, nhất quán và đầy đủ; nếu chỉ trả lại một phần dataset nhưng thiếu manifest, codebook hoặc metadata thiết yếu, trạng thái phục hồi chưa thể xem là tương đương với bộ dữ liệu đã được chấp nhận.
Dùng audit trail để truy vết và xử lý sai lệch toàn vẹn
Fixity cho biết “đã có thay đổi”; audit trail giúp trả lời “ai, khi nào và bằng hành động nào”. NIST SP 800-209 khuyến nghị bật audit logging trên hạ tầng lưu trữ, đồng bộ thời gian đáng tin cậy và tập trung log để giảm nguy cơ log bị mất hoặc bị sửa tại chính thiết bị phát sinh sự kiện.
Log có giá trị nhất khi ghi được các sự kiện trực tiếp ảnh hưởng đến integrity: write/delete, thay đổi ACL hoặc vai trò, thay đổi retention, tạo/xóa snapshot, tắt replication/backup, thay đổi cấu hình bảo vệ và các thao tác quản trị liên quan. Bản thân log cũng phải được bảo vệ. NIST khuyến nghị dữ liệu log lưu trữ được chống tampering bằng các cơ chế như WORM, immutable storage hoặc object locking, đồng thời hạn chế quyền truy cập vào log.
Quy trình xử lý khi checksum không khớp
Khi phát hiện mismatch, không nên ghi đè ngay bằng “bản có vẻ đúng”. Từ các nguyên tắc fixity, audit logging và restoration assurance có thể xây dựng quy trình: cô lập đối tượng nghi vấn, giữ nguyên bằng chứng, tính lại checksum để loại trừ lỗi thao tác, sau đó đối chiếu phiên bản, log và các recovery copy. Nếu thay đổi là hợp lệ nhưng chưa được ghi nhận, phải hoàn tất hồ sơ thay đổi và tạo baseline mới cho phiên bản đã phê duyệt. Nếu là corruption hoặc thay đổi trái phép, khôi phục từ bản sao đã vượt qua fixity check, rồi điều tra nguyên nhân trước khi đưa đối tượng trở lại luồng sử dụng.
Một chuỗi xử lý tối thiểu có thể gồm:
1. Cô lập bản dữ liệu có checksum lệch và ngăn ghi tiếp
2. Xác minh lại checksum, định danh tệp và baseline tham chiếu
3. Đối chiếu audit log, version history và trạng thái các bản sao
4. Chọn bản phục hồi đã được xác minh và thực hiện restore
5. Tính checksum sau restore, ghi nhận sự cố và chỉ tạo baseline mới khi trạng thái đã được chấp nhận
Cách làm này biến integrity từ một phép kiểm tra kỹ thuật đơn lẻ thành chuỗi bằng chứng có thể kiểm toán. Giới hạn cần lưu ý là log không còn đáng tin nếu cùng một chủ thể có thể sửa dữ liệu và xóa hoặc viết lại log; đó là lý do phải tách quyền và bảo vệ log khỏi tampering.
Xây dựng chu kỳ kiểm tra toàn vẹn theo mức độ rủi ro
Không có một tần suất fixity check phù hợp cho mọi bộ dữ liệu theo cách tiếp cận dựa trên rủi ro. NIST yêu cầu tần suất xác minh copy và audit phải tương xứng với độ nhạy và giá trị của dữ liệu, còn thực hành fixity của cộng đồng bảo quản số cũng xem tần suất là một quyết định vận hành cần cân nhắc. Vì vậy, chu kỳ nên xét giá trị nghiên cứu, mức độ nhạy cảm, tốc độ thay đổi, thời gian lưu giữ, độ tin cậy của media/hạ tầng và hậu quả nếu phát hiện corruption quá muộn; migration hoặc thay đổi cấu hình lớn là lý do hợp lý để kích hoạt kiểm tra ngoài lịch.
NIST SP 800-209 cung cấp một điểm tham chiếu định lượng cho hạ tầng lưu trữ: việc xác minh sức khỏe backup/data copy nên phù hợp với độ nhạy và giá trị của dữ liệu, nhưng không ít hơn một lần mỗi năm; tài liệu còn gợi ý tần suất lấy mẫu kiểm tra thấp hơn tần suất backup khoảng 1–1,5 bậc độ lớn, ví dụ bản sao theo giờ có thể được kiểm tra hằng ngày, còn bản sao hằng ngày có thể kiểm tra từ hai tuần một lần đến hằng tháng. Với kiểm tra cô lập recovery copy, NIST cũng khuyến nghị ít nhất hằng năm và, với hệ thống nhạy cảm hoặc giá trị cao, có thể ít nhất hằng quý hoặc sau mỗi thay đổi lớn. Đây là hướng dẫn cho storage infrastructure, không phải quy định phổ quát cho mọi dự án nghiên cứu, nên tổ chức phải hiệu chỉnh theo rủi ro và chính sách của mình.
Một chu kỳ vận hành thực tế có thể được tổ chức như sau:
· Tạo baseline checksum khi dữ liệu hoặc phiên bản được chốt
· Giới hạn quyền write/delete và tách quyền quản trị dữ liệu khỏi quyền bảo vệ backup
· Duy trì versioning cùng ít nhất một recovery copy tách biệt hoặc bất biến theo mức rủi ro
· Chạy fixity check theo lịch và sau các sự kiện như migration, restore hoặc thay đổi hạ tầng
· Ghi và bảo vệ audit trail cho các thao tác có thể thay đổi dữ liệu hoặc cơ chế bảo vệ
· Thực hiện restore test định kỳ và xác minh checksum sau khôi phục
· Điều tra mọi mismatch, khôi phục từ bản đã xác minh và cập nhật baseline chỉ sau khi trạng thái mới được chấp nhận
Mục tiêu của lịch kiểm tra không phải tạo càng nhiều phép kiểm tra càng tốt, mà là rút ngắn thời gian một sai lệch có thể tồn tại mà không bị phát hiện trong khi vẫn cân đối chi phí vận hành của việc quét và xác minh. Việc NIST gắn tần suất với độ nhạy/giá trị và yêu cầu audit sau thay đổi lớn cho thấy lịch kiểm tra nên được xem xét lại sau sự cố, thay đổi hạ tầng, thay đổi giá trị dữ liệu hoặc khi kết quả audit cho thấy kiểm soát hiện tại không còn đủ.
Để duy trì tính toàn vẹn dữ liệu nghiên cứu trong lưu trữ, cần xây dựng một chuỗi kiểm soát có thể chứng minh được: có baseline fixity để nhận biết thay đổi, có quyền truy cập và tính bất biến để hạn chế sửa/xóa trái phép, có versioning và recovery copy tách biệt để quay lại trạng thái đúng, có audit trail để truy vết, và có restore test để xác nhận bản sao thực sự phục hồi được. Cách tổng hợp này phù hợp với định nghĩa fixity của NDSA và các nhóm kiểm soát về truy cập, log, isolation và restoration assurance trong NIST SP 800-209.
Điểm quan trọng nhất là không xem bất kỳ công cụ đơn lẻ nào như “checksum”, “backup” hay “mã hóa” là lời giải trọn vẹn. Tính toàn vẹn dữ liệu nghiên cứu được duy trì khi các lớp phòng ngừa, phát hiện và phục hồi được vận hành cùng nhau, có lịch kiểm tra dựa trên rủi ro và có quy trình xử lý rõ ràng mỗi khi xuất hiện sai lệch.

GỬI Ý KIẾN BÌNH LUẬN

