
Phân biệt dữ liệu sơ cấp và dữ liệu thứ cấp
Mục lục
- Dữ liệu sơ cấp và thứ cấp khác nhau ở nguồn và mục đích
- Dữ liệu sơ cấp được tạo riêng cho nghiên cứu hiện tại
- Dữ liệu thứ cấp được tái sử dụng từ nguồn đã tồn tại
- Hai loại dữ liệu khác nhau về kiểm soát, độ phù hợp và nguồn lực
- Chọn dữ liệu sơ cấp hay thứ cấp theo khoảng trống thông tin
- Phân loại theo bối cảnh giúp tránh nhầm lẫn về dữ liệu
Dữ liệu sơ cấp được thu thập riêng cho mục tiêu nghiên cứu hiện tại, còn dữ liệu thứ cấp đã tồn tại từ trước và được tái sử dụng. Hiểu nguồn gốc, mục đích, mức độ kiểm soát và giới hạn của từng loại giúp lựa chọn dữ liệu phù hợp hơn.
Điểm khác biệt cốt lõi giữa dữ liệu sơ cấp và dữ liệu thứ cấp nằm ở nguồn hình thành dữ liệu và mục đích ban đầu của việc thu thập. Dữ liệu sơ cấp được thu thập trực tiếp để giải quyết câu hỏi của nghiên cứu hiện tại. Dữ liệu thứ cấp là dữ liệu đã được tạo ra trước đó cho một nghiên cứu, hoạt động hoặc mục đích khác rồi được sử dụng lại.
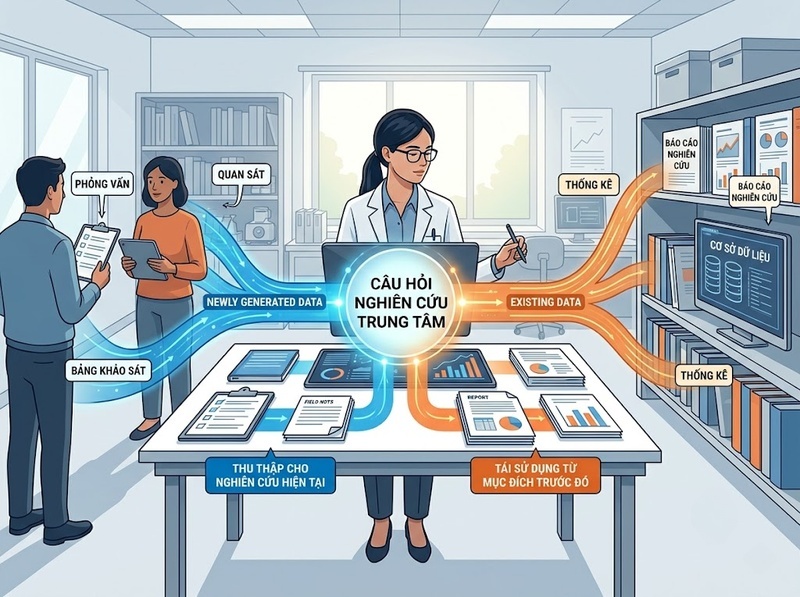
Vì vậy, không nên phân loại chỉ dựa vào việc dữ liệu nằm trên Internet, do chính doanh nghiệp sở hữu hay có ở dạng dữ liệu thô. Một tập dữ liệu có thể là sơ cấp đối với bên trực tiếp thiết kế và thực hiện việc thu thập nhưng trở thành dữ liệu thứ cấp đối với một người nghiên cứu khác sử dụng lại tập dữ liệu đó.
Dữ liệu sơ cấp và thứ cấp khác nhau ở nguồn và mục đích
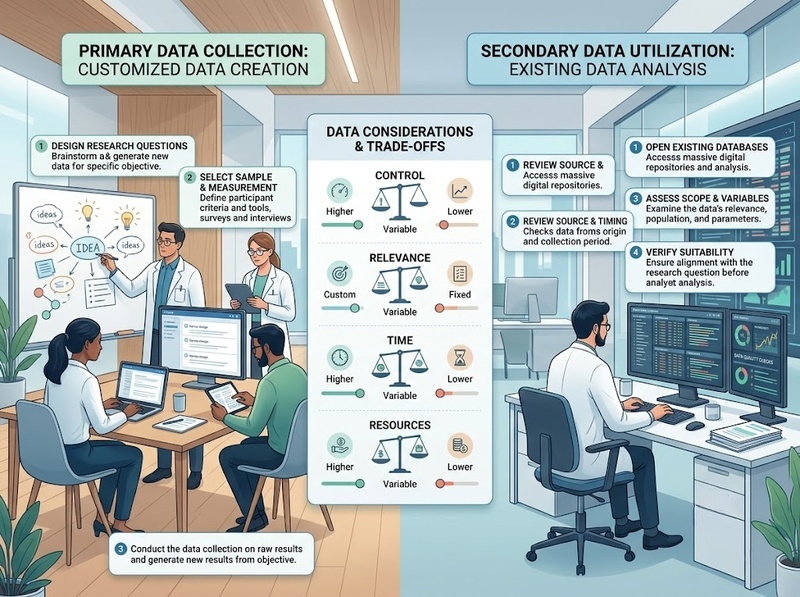
Trong phương pháp nghiên cứu, dữ liệu sơ cấp là dữ liệu được tạo ra thông qua một quá trình thu thập được thiết kế cho vấn đề đang nghiên cứu. Người nghiên cứu xác định cần biết điều gì, cần đo biến nào, tiếp cận đối tượng nào và sử dụng công cụ nào trước khi dữ liệu được hình thành.
Ngược lại, dữ liệu thứ cấp đã tồn tại trước khi nghiên cứu hiện tại sử dụng đến nó. Dữ liệu có thể đến từ báo cáo, cơ sở dữ liệu, thống kê công bố, hồ sơ hành chính, dữ liệu giao dịch, kết quả khảo sát trước đây hoặc một nghiên cứu đã hoàn thành.
Có thể nhìn sự khác biệt qua các tiêu chí chính:
|
Tiêu chí |
Dữ liệu sơ cấp |
Dữ liệu thứ cấp |
|
Nguồn hình thành |
Thu thập trực tiếp từ đối tượng, sự kiện hoặc hiện tượng cần nghiên cứu |
Lấy từ dữ liệu đã được thu thập và lưu trữ trước đó |
|
Mục đích ban đầu |
Phục vụ trực tiếp câu hỏi nghiên cứu hiện tại |
Ban đầu phục vụ một mục đích khác hoặc nghiên cứu khác |
|
Thiết kế thu thập |
Người nghiên cứu có thể chủ động thiết kế |
Thiết kế đã được quyết định từ trước |
|
Khả năng kiểm soát |
Có thể kiểm soát biến đo, đối tượng, mẫu và công cụ thu thập |
Phụ thuộc vào cách dữ liệu ban đầu được tạo ra |
|
Mức độ phù hợp |
Thường có thể điều chỉnh sát câu hỏi hiện tại |
Cần đánh giá xem dữ liệu có thực sự phù hợp hay không |
|
Thời gian và nguồn lực |
Thường cần nhiều thời gian và nguồn lực hơn |
Thường có thể khai thác nhanh hơn nếu dữ liệu sẵn có |
Bảng này cho thấy “sơ cấp” không đồng nghĩa với “tốt hơn”, còn “thứ cấp” cũng không đồng nghĩa với “kém chính xác”. Chất lượng phụ thuộc vào cách dữ liệu được thu thập, khả năng đại diện, phương pháp đo lường và mức độ phù hợp với câu hỏi cần trả lời.
Dữ liệu sơ cấp được tạo riêng cho nghiên cứu hiện tại
Cơ chế hình thành dữ liệu sơ cấp bắt đầu từ nhu cầu thông tin của nghiên cứu hiện tại. Người nghiên cứu xác định khoảng trống cần làm rõ, chuyển nó thành các biến hoặc thông tin cần thu thập, lựa chọn đối tượng và phương pháp, sau đó mới tạo dữ liệu.
Ví dụ, một doanh nghiệp muốn biết mức độ hài lòng của khách hàng sau khi thay đổi quy trình phục vụ. Nếu doanh nghiệp thiết kế bảng hỏi và khảo sát nhóm khách hàng vừa trải nghiệm quy trình mới, các câu trả lời thu được là dữ liệu sơ cấp đối với nghiên cứu đó.
Dữ liệu sơ cấp có thể được hình thành qua khảo sát, phỏng vấn, quan sát, thí nghiệm, đo lường hoặc các phương pháp thu thập trực tiếp khác. Điều làm chúng trở thành dữ liệu sơ cấp không phải bản thân công cụ khảo sát hay phỏng vấn, mà là việc quá trình thu thập được tổ chức nhằm phục vụ câu hỏi hiện tại.
Ưu thế lớn của cách tiếp cận này là mức độ kiểm soát. Người nghiên cứu có thể quyết định đối tượng nào cần được khảo sát, câu hỏi được đặt ra như thế nào, thời điểm thu thập, cách định nghĩa biến và tiêu chuẩn xử lý dữ liệu.
Tuy nhiên, quyền kiểm soát cao không tự động bảo đảm chất lượng cao. Một khảo sát được thiết kế không phù hợp, mẫu bị lệch hoặc câu hỏi gây dẫn dắt vẫn có thể tạo ra dữ liệu sơ cấp kém giá trị. Vì vậy, bản chất “sơ cấp” nói về quan hệ giữa dữ liệu và quá trình nghiên cứu, không phải chứng nhận về độ chính xác.
Dữ liệu thứ cấp được tái sử dụng từ nguồn đã tồn tại
Dữ liệu thứ cấp vận hành theo một cơ chế khác: nghiên cứu hiện tại không bắt đầu bằng việc tạo dữ liệu mới mà bằng việc tìm kiếm, đánh giá và tái sử dụng dữ liệu đã có.
Chẳng hạn, khi nghiên cứu quy mô một thị trường, người nghiên cứu có thể sử dụng số liệu dân số, thu nhập hoặc hoạt động kinh tế đã được cơ quan thống kê công bố. Những số liệu này không được thu thập riêng để trả lời câu hỏi của nghiên cứu thị trường hiện tại nên chúng được sử dụng với vai trò dữ liệu thứ cấp.
Điểm quan trọng là người sử dụng dữ liệu thứ cấp không kiểm soát được toàn bộ quyết định đã tạo ra dữ liệu. Khái niệm, mẫu, thời gian thu thập, phạm vi địa lý, đơn vị đo hoặc cách xử lý có thể đã được xác lập từ trước. Do đó, công việc quan trọng không chỉ là “tìm được dữ liệu” mà còn phải kiểm tra dữ liệu đó có tương thích với vấn đề hiện tại hay không.
Dữ liệu thứ cấp có thể rất có giá trị khi nguồn dữ liệu có phương pháp rõ ràng và phạm vi phù hợp. Ngược lại, một bộ dữ liệu dù lớn vẫn có thể không hữu ích nếu được thu thập ở thời điểm khác, cho nhóm đối tượng khác hoặc sử dụng định nghĩa không phù hợp với nghiên cứu hiện tại.
Đây cũng là lý do dữ liệu thứ cấp không nên được đánh giá chỉ dựa trên việc nó đã cũ hay do người khác thu thập. Điều cần đánh giá là mục đích ban đầu, phương pháp tạo dữ liệu và mức độ phù hợp với mục đích sử dụng mới.
Hai loại dữ liệu khác nhau về kiểm soát, độ phù hợp và nguồn lực
Nguồn và mục đích là tiêu chí phân biệt nền tảng, nhưng sự khác biệt đó kéo theo những hệ quả thực tế về mức độ kiểm soát, tính phù hợp, thời gian và chi phí.
Với dữ liệu sơ cấp, người nghiên cứu có thể thiết kế quá trình thu thập xoay quanh chính câu hỏi cần trả lời. Nếu cần đo một thuộc tính rất cụ thể hoặc nghiên cứu một nhóm đối tượng chưa từng được khảo sát, dữ liệu sơ cấp có khả năng đáp ứng trực tiếp hơn.
Đổi lại, phải xây dựng công cụ, tuyển chọn đối tượng, tổ chức thu thập, kiểm tra và xử lý dữ liệu. Quá trình này thường tiêu tốn nhiều nguồn lực hơn so với việc khai thác một nguồn dữ liệu đã có.
Dữ liệu thứ cấp đảo ngược một phần sự đánh đổi đó. Nếu nguồn phù hợp đã tồn tại, người nghiên cứu có thể nhanh chóng tiếp cận lượng thông tin lớn mà không cần tái tạo toàn bộ quá trình thu thập. Đây là lợi thế rõ rệt khi cần nghiên cứu bối cảnh, nhận diện xu hướng hoặc kiểm tra xem đã có đủ thông tin để trả lời câu hỏi hay chưa.
Nhưng lợi thế về khả năng tiếp cận đi kèm với giới hạn về kiểm soát. Một biến quan trọng có thể không được đo, nhóm đối tượng cần nghiên cứu có thể không được tách riêng, hoặc cách định nghĩa chỉ tiêu có thể khác với định nghĩa đang cần sử dụng.
Do đó, không có nguyên tắc chung rằng dữ liệu sơ cấp luôn ưu việt hơn dữ liệu thứ cấp. Dữ liệu phù hợp hơn là dữ liệu đáp ứng được câu hỏi nghiên cứu với chất lượng, phạm vi và điều kiện sử dụng chấp nhận được.
Chọn dữ liệu sơ cấp hay thứ cấp theo khoảng trống thông tin
Một cách lựa chọn hợp lý là bắt đầu từ thông tin cần có, thay vì mặc định phải thu thập dữ liệu mới.
Trước tiên, cần xác định chính xác câu hỏi nghiên cứu và những dữ liệu cần thiết để trả lời. Sau đó kiểm tra các nguồn dữ liệu đã tồn tại. Nếu dữ liệu thứ cấp có phạm vi, thời gian, đối tượng, biến số và phương pháp phù hợp, việc sử dụng nguồn sẵn có có thể tránh được một quá trình thu thập không cần thiết.
Nếu dữ liệu hiện có không trả lời được câu hỏi, thiếu biến quan trọng hoặc không phản ánh đúng nhóm đối tượng, dữ liệu sơ cấp trở thành phương án để lấp khoảng trống đó.
Trong thực tế, hai loại dữ liệu thường bổ sung cho nhau thay vì loại trừ nhau. Dữ liệu thứ cấp có thể được sử dụng trước để hiểu bối cảnh và xác định điều chưa biết. Sau đó, dữ liệu sơ cấp tập trung vào những vấn đề mà nguồn sẵn có chưa giải đáp.
Ví dụ, doanh nghiệp có thể sử dụng dữ liệu bán hàng trong quá khứ để nhận biết một nhóm sản phẩm đang giảm doanh số. Nếu dữ liệu này không giải thích được nguyên nhân, doanh nghiệp có thể thực hiện phỏng vấn hoặc khảo sát khách hàng để thu thập dữ liệu sơ cấp về lý do thay đổi hành vi.
Cách kết hợp này giúp tránh hai cực đoan: thu thập dữ liệu mới khi chưa cần thiết hoặc phụ thuộc vào dữ liệu sẵn có dù nó không đủ phù hợp để trả lời câu hỏi.
Phân loại theo bối cảnh giúp tránh nhầm lẫn về dữ liệu
Một trong những hiểu nhầm phổ biến nhất là cho rằng loại dữ liệu được quyết định cố định bởi định dạng hoặc nơi lưu trữ. Thực tế, việc phân loại phải xem xét dữ liệu được tạo ra cho mục đích nào và đang được ai sử dụng cho nghiên cứu nào.
Giả sử một nhóm nghiên cứu tự thực hiện khảo sát 1.000 người. Với nhóm đó, bộ câu trả lời là dữ liệu sơ cấp vì được thu thập trực tiếp cho nghiên cứu của họ. Nếu một nhóm khác lấy chính bộ dữ liệu này để thực hiện một nghiên cứu mới, nó trở thành dữ liệu thứ cấp đối với nghiên cứu thứ hai.
Tương tự, dữ liệu do chính doanh nghiệp sở hữu không nhất thiết là dữ liệu sơ cấp cho mọi nghiên cứu của doanh nghiệp. Hồ sơ giao dịch được hệ thống bán hàng ghi nhận để vận hành kinh doanh, sau đó được lấy ra phục vụ một nghiên cứu hành vi khách hàng mới, có thể được xem là dữ liệu thứ cấp trong bối cảnh nghiên cứu đó vì nó đã tồn tại và ban đầu được tạo ra cho một mục đích khác.
Ngược lại, dữ liệu được thu thập bởi một đơn vị bên ngoài theo hợp đồng nhưng được thiết kế riêng cho câu hỏi của nghiên cứu hiện tại vẫn có thể mang bản chất dữ liệu sơ cấp. Người nghiên cứu không nhất thiết phải tự tay thực hiện từng cuộc phỏng vấn; yếu tố quyết định là dữ liệu được tạo ra riêng cho mục tiêu nghiên cứu hiện tại.
Cũng cần tách khái niệm sơ cấp – thứ cấp khỏi những cách phân loại khác. Dữ liệu định tính hay định lượng, dữ liệu nội bộ hay bên ngoài là các chiều phân loại khác nhau. Một cuộc phỏng vấn có thể tạo dữ liệu sơ cấp định tính, trong khi một bảng thống kê số liệu có thể là dữ liệu thứ cấp định lượng. Không nên dùng một chiều phân loại để thay thế cho chiều còn lại.
Dữ liệu sơ cấp và dữ liệu thứ cấp khác nhau trước hết ở nguồn hình thành và mục đích thu thập ban đầu. Dữ liệu sơ cấp được tạo ra để phục vụ trực tiếp nghiên cứu hiện tại nên cho phép kiểm soát tốt hơn đối với thông tin cần thu thập. Dữ liệu thứ cấp đã tồn tại từ trước nên thường thuận tiện hơn để khai thác nhưng phải được đánh giá kỹ về mức độ phù hợp. Lựa chọn hiệu quả không phải là luôn ưu tiên một loại, mà là sử dụng dữ liệu sẵn có khi nó đủ đáp ứng và thu thập dữ liệu mới khi vẫn còn khoảng trống thông tin cần giải quyết.

GỬI Ý KIẾN BÌNH LUẬN
Có thể bạn quan tâm

Bài xem nhiều

-
Kích thước thang máy Mitsubishi 450kg tiêu chuẩn là bao nhiêu?
-
Hướng dẫn nuôi cá rô phi đơn tính nhanh lớn cho năng suất cao
-
Cá chép giòn thích ăn gì nhất và có cần thay đổi theo mùa không?
-
Cắt amidan uống trà sữa được không? Khi nào mới uống lại được
-
Cá rô đồng ăn ở tầng nước nào để nuôi hoặc câu hiệu quả nhất